exp1:跑马灯
目标:
目前阶段大家应该没有板子,所以最终目标是获取bitstream即可
- 找个你喜欢的地方新建工程,尽可能在路径浅的地方,例如直接在
D:/。vivado对路径有着260字符的限制,后续可能会自动创建一级一级的目录,maybe就会爆掉。当然安装的时候就提到的工程名称和存储路径中不能出现中文字符和空格依然要遵守。 - 添加设计文件
scroller.v和仿真文件testbench.v。 - 仿真一下试试,判断设计是否与目的相符
- 添加约束文件
scroller.xdc,运行综合、实现、生成比特流 - 恭喜完成第一份fpga设计任务
exp2:寄存器堆仿真
目标:
- verilog基础知识
- rtl模块设计流程
需求分析
一般而言对于一个rtl模块设计,首先需要的是知晓其功能和接口。在本exp中,rtl功能为“两读一写”的寄存器堆,其接口如下:
| 名称 | 宽度 | 方向 | 描述 |
|---|---|---|---|
| clk | 1 | input | 时钟信号 |
| raddr1 | 5 | input | 寄存器堆读地址1 |
| rdata1 | 32 | output | 寄存器堆读返回数据1 |
| raddr2 | 5 | input | 寄存器堆读地址2 |
| rdata2 | 32 | output | 寄存器堆读返回数据2 |
| we | 1 | input | 寄存器堆写使能 |
| waddr | 5 | input | 寄存器堆写地址 |
| wdata | 32 | input | 寄存器堆写数据 |
如果你不了解寄存器堆是什么的话,想想快递柜?
设计rtl
想想你会怎么设计这个寄存器堆,该如何控制读写其中的寄存器,自己动手试一下吧。
仿真测试
将你自己写的代码进行仿真测试,对比给出的代码,分析一下有什么区别。
0地址强制读全0是loongarch指令集中定义的,如果你自己的设计没有这一部分的话,不重要(因为本exp需求中也没说)。不过后续设计的时候一定要关注满足这种定义类的需求。
exp3:同步RAM和异步RAM
目标:
同步与异步
同步,如其名,就是大家一起动。这是由我们之前学习的时序电路所实现的,大家都通过同一个时钟源同拍而动。而异步,~~就是它们不同步(废话),~~则各动各的,没有什么固定关系。
结合verilog代码,可以简单的理解为阻塞赋值就是异步置位,非阻塞赋值就是同步置位。注意关注仿真中两种实现对于“请求数据”和“读到数据”之间的区别。
block ram 与 distributed ram
block ram常被简称为BRAM,它是由原生在FPGA内部的一块寄存器堆。而distributed ram(分布式ram)则是由LUT资源所搭建起来的ram。两者写都是同步的,但前者原生只支持同步读取,而后者原生只支持异步读取。
时序报告
时序报告我们最关注的是WNS和TNS,前者称为最坏路径/关键路径(Worst Negative Slack),后者则是所有最坏路径的总和(Total Negative Slack)。目前我们只需要关注其正负即可,正就是ok、负就是完蛋。你看到那个鲜艳的红色了吗
简单的来说,WNS就是指这个寄存器变化后经过一系列逻辑运算能不能即时到达下一个寄存器中。也就是运算的延迟不能超过一个时钟周期,超过的话就不能保证数据正确性了。换句话说,这就是超频
资源报告
资源主要关注LUT和RAM,这两者可以简单的认为是片上的总资源。而这两歌资源建议全部都控制在90%以下,否则实现很容易爆炸掉(指由于没地方布线导致WNS爆红)
exp4:设计与调试
开始你的排雷(debug)之旅吧,建议先学一下宝典
调试Tips
- 特别特别熟悉你的设计目的
- 理解tb,它也是你的设计
exp5:5条指令单周期CPU
目标:
- 熟悉寄存器堆、RAM和基本仿真调试方法
- 理解CPU如何取出、解释并执行一条指令
- 阅读miniCPU的数据通路,补全缺失的代码
- 通过斐波那契程序验证CPU功能
实验环境
本exp使用minicpu_env/,需要补全的代码在miniCPU/中。先找到下面几个文件:
| 文件或目录 | 注释 |
|---|---|
miniCPU/minicpu_top.v | CPU顶层 |
miniCPU/regfile.v | 通用寄存器堆 |
func/inst_ram.txt | 测试程序的汇编说明 |
func/inst_ram.coe | 给指令RAM配置测试程序的初始化文件 |
soc_verify/testbench/minicpu_tb.v | 仿真激励 |
soc_verify/run_vivado/create_project.tcl | 创建工程脚本 |
soc_verify/run_vivado/constraints/soc_mini_top.xdc | 约束文件 |
单周期CPU在做什么
先把CPU想象成一个按顺序执行任务的电路。PC保存当前指令的地址,指令RAM根据这个地址给出机器码;译码逻辑判断机器码表示什么操作,再控制寄存器堆、加法器和访存接口完成这件事。
这里的取指、译码、执行、访存、写回是一条指令的处理步骤,现在还没有把它们拆成五级流水线。单周期设计需要在一个时钟周期内完成本条指令所需的组合逻辑计算,再在相应时钟沿更新PC、寄存器等状态。
五条指令的数据流
本实验涉及add.w、addi.w、ld.w、st.w、bne,具体指令定义可参考LoongArch32r指令表。先不看机器码,直接把每条指令翻译成数据怎么流:
| 指令 | 需要读取什么 | 计算什么 | 最后修改什么 |
|---|---|---|---|
add.w rd, rj, rk | rj、rk | 两个寄存器的值相加 | 将和写入rd |
addi.w rd, rj, si12 | rj | 加上符号扩展后的立即数 | 将和写入rd |
ld.w rd, rj, si12 | rj | 基址加偏移,得到访存地址 | 将读回的数据写入rd |
st.w rd, rj, si12 | rj、rd | 基址加偏移,得到访存地址 | 将rd的值写到该地址 |
bne rj, rd, offs16 | rj、rd | 比较两者是否不相等,计算目标地址 | 条件成立时改变下一条PC |
这样一看,addi.w、ld.w、st.w计算的其实都是“寄存器值加立即数”,完全可以共用加法器。区别是加出来的值接下来送到哪里:写回寄存器,还是送到数据接口作为地址。
填空的时候建议沿着译码—读寄存器—选择运算输入—选择写回结果—更新PC这条线检查,而不是看到一个空就单独猜一个表达式。
寄存器地址选择
LoongArch中,这几条指令的rd位于inst[4:0],rj位于inst[9:5],add.w的rk位于inst[14:10]。
注意**rd这个字段不一定是目的寄存器。** 在st.w中它是要写出去的数据,在bne中它是参与比较的另一个数。因此寄存器堆的第二个读地址需要选择。
相应地,写寄存器的指令只有add.w、addi.w、ld.w。st.w和bne不能因为编码中也有rd字段就打开写使能。
立即数与分支目标
addi.w、ld.w、st.w使用的12位立即数要先符号扩展再参与地址或数据计算,不能直接在高位补0。遇到负偏移时,两者的结果可就差远了。
bne使用的是16位分支偏移字段,需要在低位补两个0,再符号扩展到32位。下面的i12、i16都是直接从机器码中取出的原始字段:
| |
注意目标地址以当前分支指令的PC为基准,偏移低位补0只做一次。
仿真
完成填空后,通过tcl创建工程,确认指令RAM使用了func/inst_ram.coe,再运行仿真。综合实现时,设计顶层为soc_mini_top,与CPU顶层minicpu_top不同。
本exp运行的是斐波那契程序。手册把数列0、1、1、2、3、5……中的第三项定义为f(1),因此:
| 程序输入n | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| 期望结果f(n) | 1 | 2 | 3 | 5 | 8 |
通过修改minicpu_tb.v中的switch输入选择n,每次修改后重新仿真,观察程序最终写出的结果。
调试Tips
- 先找第一条执行错误的指令。最终LED值不对只是结果,真正出错的位置可能在很早之前。
- PC不动先看时钟、复位和下一条PC逻辑;指令全0或全X先看RAM初始化和接线。
add.w正常而addi.w不对,优先查立即数扩展和加法器输入选择,相似的指令查找执行不同之处。ld.w读错数据可能是st.w就错了,或者地址算错了。- 仿真波形中需要观察的信号可以参考调试技巧提前记录、分组。先手动调完一小段程序,你会发现CPU的运行其实很简单( ‘◟ ‘)✧
exp6:20条指令单周期CPU
目标:
- 学习使用龙芯提供的基于trace比对的调试框架
- 学习龙芯提供的单周期CPU的数据通路
- 学习基本仿真调试思路
- 学习使用trace比对的CPU系统调试
数据通路
数据通路是芯片上最重要的“路”之一,介于初学时对CPU的数据通路不够了解,自己动手拼搭模块会无从下手,我们建议学习现有的CPU的数据通路,这里我们采用龙芯实验代码仓库中提供的单周期CPU(存在错误需要调试)。
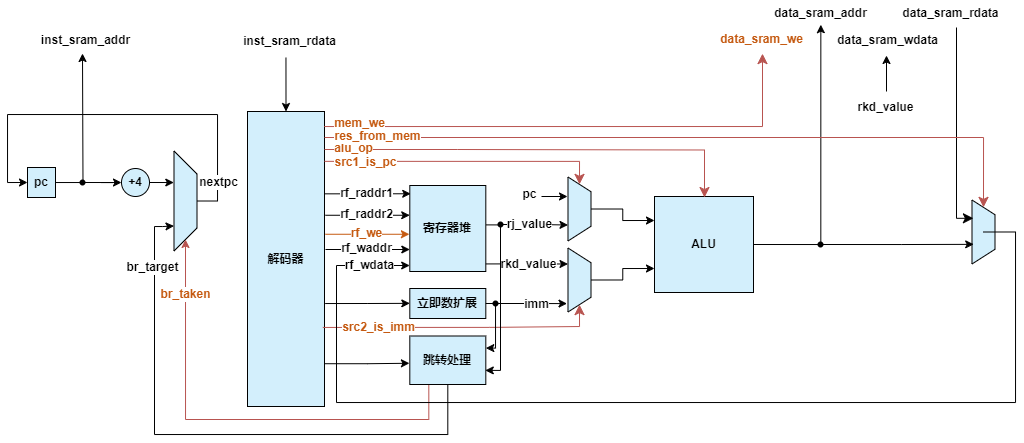
简单的数据通路结构图,请自己理解给出的单周期CPU的结构、不同部件之间如何协同工作、各个控制信号如何控制数据的流动。
CPU的debug实际上就是在观察数据通路上各处流动的数据是不是我们想要的数据,然后修改控制信号的逻辑或者数据通路本身以获得预期结果。
调试Tips
- 善用反汇编文件(
func/obj/test.s)查询某个PC对应的指令 - 当CPU的第一条指令都没有成功运行,而你一点思路都没有的话,不妨试着在数据通路图上模拟运行一遍第一条指令
- 运行过程中的Error一般出在之前成功运行的指令都没有用的部分
exp7:不考虑相关冲突处理的简单流水线CPU
目标:
- 学习流水线的基本概念(课上讲义、百度、计算机体系结构基础)
- 多周期CPU的概念
- 修改单周期CPU,使其流水线化
流水线的作用
随着CPU电路中组合逻辑部分越来越复杂,其延迟也必然增大,整个电路的频率就会变低。
在单周期CPU中,每个时钟周期必须完成取指、译码、读寄存器、执行、访存等很多组合逻辑工作,为了保证在下一个时钟上升沿到来之前准备好寄存器堆的写数据,需要将每个时钟周期的间隔拉长,导致处理器的主频无法提高,使用流水线技术可以提高处理器的主频。
在这里我将跳过流水线的基本概念,直接分析经典的五级静态单发射流水线CPU。
修改步骤
划分流水级
按照经典五级流水线,我们将单周期CPU的处理流程划分为五个阶段:
- IF(取指):从指令存储器读取指令。
- ID(译码):解析指令,读取寄存器堆数据。
- EX(执行):执行算术/逻辑运算或计算地址。
- MEM(访存):访问数据存储器(如加载/存储指令)。
- WB(写回):将结果写回寄存器堆。
插入流水线寄存器
在流水线中,每一级都可能处理着不同的指令,这时我们就需要一些存储当前级指令信息的级间寄存器,这些级间寄存器储存着指令相关的数据和控制信息以供当前级处理使用。
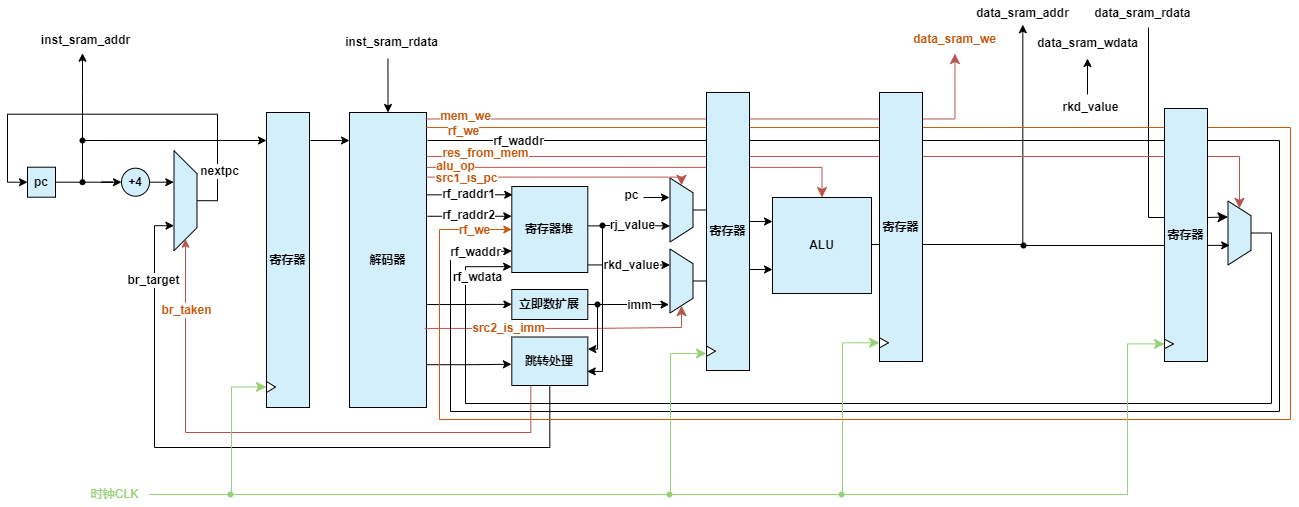
调试Tips
- 调整CPU顶层接口,增加指令RAM的片选信号
inst_sram_en和数据RAM的片选信号data_sram_en - 调整CPU顶层接口,将
inst_sram_we和data_sram_we都从1比特的写使能调整为4比特的字节写使能 - 在流水线CPU中,调试定错可以基于级间寄存器的内容判断
- 各级流水线中命名需要有命名逻辑,很容易找不到
exp8:阻塞技术解决相关引发的冲突
目标:
- 流水线CPU的运行过程
- 流水线冲突以及如何处理流水线冲突(阻塞方法)
流水线冲突
流水线冲突(Hazard) 是指由于指令在流水线中并行执行时产生的依赖关系或资源竞争,导致后续指令无法正常执行的现象。主要分为三类:数据相关、控制相关和结构相关。
数据冲突
数据相关根据冲突访问读和写的次序可以分为3种。
- 写后读(Read After Write,简称RAW)相关,即后面指令要用到前面指令所写的数据,也称为真相关。
- 写后写(Write After Write,简称WAW)相关,即两条指令写同一个单元,也称为输出相关。
- 读后写(Write After Read,简称WAR)相关,即后面的指令覆盖前面指令所读的单元,也称为反相关。
在静态五级流水线CPU中,仅会出现RAW相关流水线冲突,WAW和WAR在乱序流水线中需要考虑。
对于以下两条指令:
| |
第2条指令的源寄存器r2为第1条指令的目的寄存器,即存在RAW相关。其时空图如下:
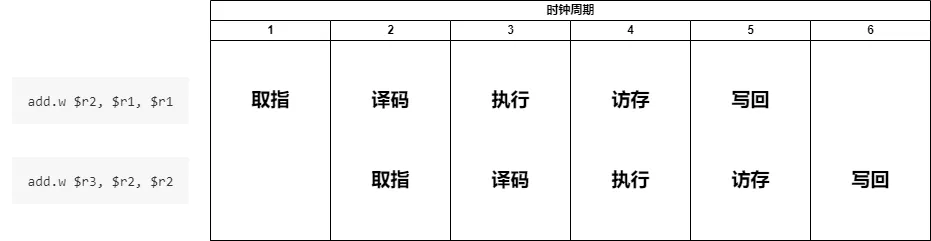
我们注意到在第3个时钟周期时,第2条指令读取r2寄存器的值,但此时第1条指令未执行写回,也就是说读取到r2寄存器的值并非是最新的、正确的值,第2条指令的运行数据必然是错误的。
为了保证执行的正确,一种最直接的解决方式是让第2条指令在译码阶段等待(阻塞)3拍,直到第1条指令将结果写入寄存器后才能读取寄存器,进入后续的执行阶段。这时时空图如下:
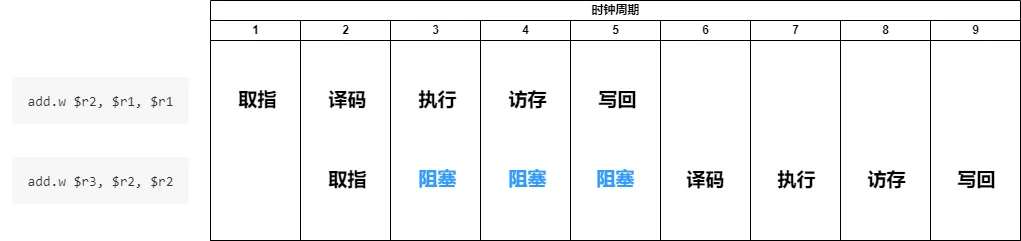
控制冲突
控制冲突主要是由于分支/跳转指令导致后续指令的取指目标不确定。
对于以下的指令序列:
| |
其时空图如下:
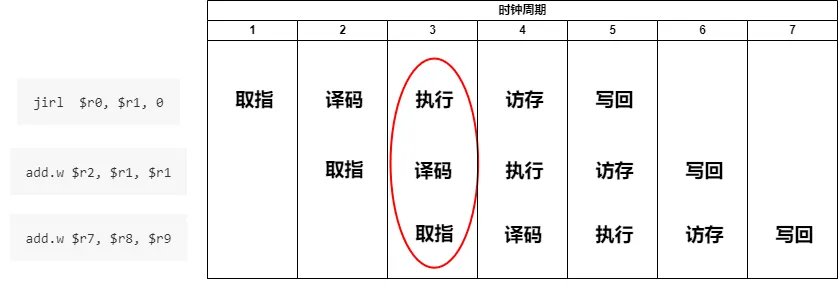
我们注意到在第3周期jirl指令被执行的时候,两条add.w指令已经进入流水线,而这两条指令是不需要被执行的,这就引发了控制冲突。
为了解决这个问题,可以通过在取指阶段引入2拍的流水线阻塞来解决,此时时空图如下:
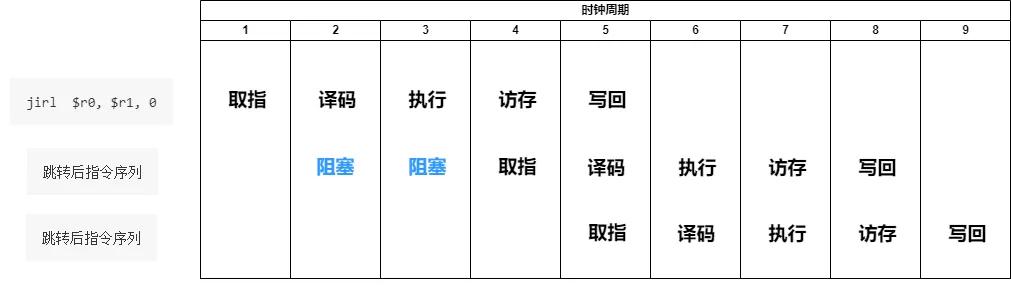
在单发射5级静态流水线中,如果增加专用的运算资源将转移指令条件判断和计算下一条指令PC的处理调整到译码阶段,那么转移指令后面的指令只需要在取指阶段等1拍。
在前文中的数据通路图中,我其实已经将跳转处理调整到译码阶段了。
为更进一步减少由控制相关引起的阻塞,可以采用转移指令的延迟槽技术,在定义指令系统的时候就明确转移指令延迟槽指令的执行不依赖于转移指令的结果(如MIPS),这样转移指令后面的指令在取指阶段1拍也不用等。
另外一种思路是分支预测,通过合理的方式对跳转目标PC的预测以消除等待计算的时间,具体可参考《超标量处理器设计》一书中分支预测相关部分。
结构冲突
结构相关引起冲突的原因是两条指令要同时访问流水线中的同一个功能部件。
回顾前文中使用阻塞处理冲突时,被阻塞的指令之后的指令也由于执行部件被占用而无法在流水线中执行,一起被堵在后面。
再回顾前文中数据通路,我们发现有指令、数据两个存储器(哈佛架构),这其实也是为了解决取指和访存同时读取存储器的结构冲突。
流水线冲突的解决
流水线冲突的解决方式主要分为两种:阻塞和旁路。
阻塞
在前文讲解流水线冲突的过程中,我们均采用的是阻塞方法,即一个字:等!等到该准备的都准备好了再执行。其优点是控制逻辑简单,无需添加很多电路单元;当然其缺点也很明显,CPU大部分时间都在摸鱼了,造成了很大的性能浪费。
旁路
旁路技术主要原理是添加一些专用计算模块,以降低甚至消除阻塞时间,体现了芯片设计中的以空间换时间的思路。
例如前文中将分支跳转的执行从执行级调整到译码级,并增加专用的分支跳转模块。
修改方式
将流水线中添加阻塞控制的思路在这里提供两种:
控制单元
添加一个流水线运行控制单元,其负责处理各级流水线发出的阻塞请求,并给各流水级发出阻塞信号,阻塞信号作为级间寄存器的使能信号即可。
握手机制
握手机制需要在各级流水线中添加握手信号,当两方握上手后使能级间寄存器。
| |
for_valid为前级有效信号next_allowin为后级允许进入信号buffer为级间寄存器for_input为前级输入数据
注意如果使用后级允许进入信号生成本级允许信号的话,可能会使关键路径贯穿整个流水线,在流水线深度较深的情况下需要注意。
调试Tips
- 在已有部件正确的情况下,只需要判断新加入的部件是否正常运行
- 优先关注控制信号是否正确
- 如果需要可以先进行单独部件的仿真测试
exp9:前递技术解决相关引发的冲突
目标:
- 流水线冲突的概念及阻塞处理实现
- 使用前递技术处理数据冲突
前递技术
让我们重新观察使用阻塞方式处理数据冲突的时空图:
对于add.w指令,在流水线的执行级已经将结果计算出,如果我们可以提前将结果发送给译码级处,就不用阻塞流水线等待了,这就是流水线前递(Forwarding)技术。同样,我们也要添加访存级、写回级的数据前递回译码级的数据通路。
数据通路
以下是添加了前递通路的数据通路参考:
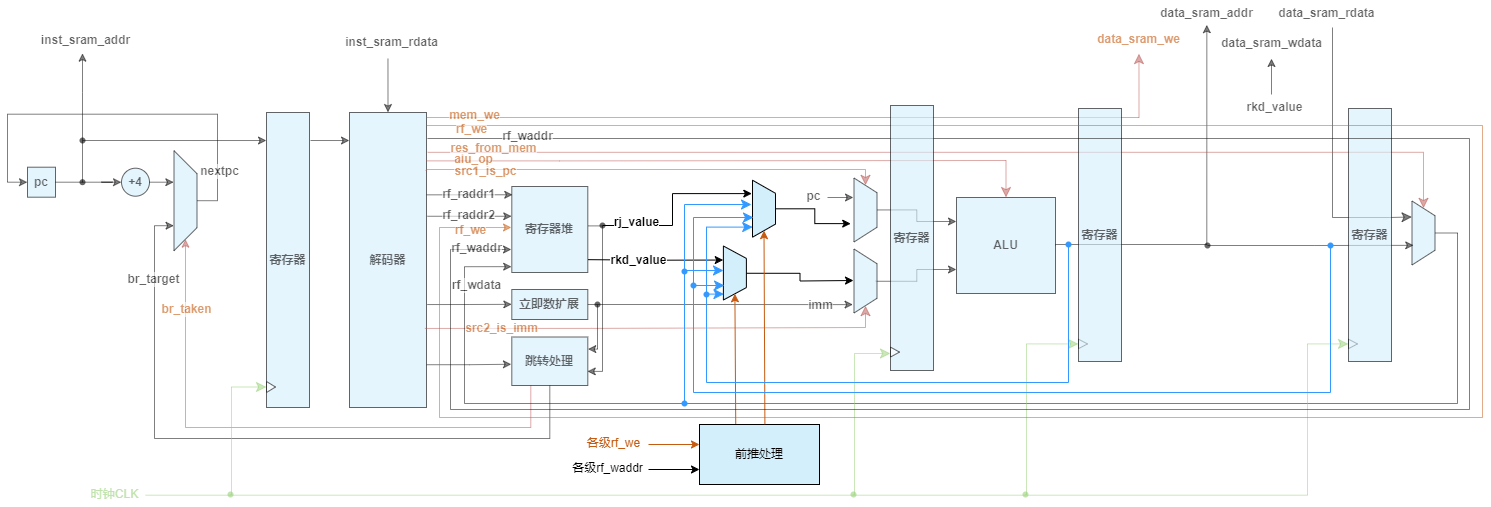
调试Tips
- 同样的我们几乎只需要关注前推处理的逻辑
- 注意
ld.w等访存指令需要在访存级结束才能有正确数据
exp10:算术逻辑运算指令和乘除法运算指令添加
目标:
算术逻辑运算类指令
需要添加的指令有slti、sltui、andi、ori、xori、sll.w、srl.w、sra.w、pcaddu12i,指令具体信息可参考我的LoongArch32r指令表。
首先,我们来观察需要添加的指令有什么特点、和我们已有的指令有什么联系吗?
slti、sltui等与已添加的指令slt、sltu等仅在源操作数2从寄存器还是立即数中取值有区别,所以我们可以几乎复用slt、sltu等指令的数据通路,仅需在源操作数2的仲裁信号src2_is_imm处修改即可sll.w、srl.w等与已添加的指令slli.w、srli.w等仅在源操作数2从寄存器还是立即数中取值有区别,所以我们也可以复用pcaddu12i指令实际上等同addi.w的运算过程,只不过源操作数1为该指令的PC值,源操作数2的立即数处理为在最低位后接12bit零,所以我们只需增加一些仲裁和处理逻辑即可
你可能会在添加
pcaddu12i的时候注意到,源操作数1的仲裁信号(src1_is_pc)和源操作数2的立即数处理和仲裁信号(need_si20、src2_is_imm)已经存在了,不需要额外添加。如果你傻乎乎的又新加了两块逻辑,那么你应该重新复习一下完整的数据通路了。当我们需要新添加一些东西的时候,首先需要考虑一下能否复用已有的,或者进行一些小小的修改,而非直接开堆。冗杂的堆砌不仅是对资源的浪费,对代码可读性也是一种灾难。
经过这一通分析,我想完成这9条指令对你来说是易如反掌了吧( ‘◟ ‘)✧
你可以现在开始仿真debug,当pass了29个点的时候这些指令就没问题了,也可以接着添加最后一起仿真debug。
乘除运算类指令
需要添加的指令有mul.w、mulh.w、mulh.wu、div.w、mod.w、div.wu、mod.wu,指令具体信息可参考我的LoongArch32r指令表。
首先,我们还是分析一下这些指令
- 没有乘除法运算单元,肯定要添加乘除法器
(或者你也可以试试用加减法来算) - 数据流动与
add.w等 3R-type 指令相同,仅运算方式不一样(指令编码格式相同的指令的数据流动几乎相同) - 指令间的区别为有/无符号运算、如何选取结果输出
这样来说,我们只需要新加一个乘除法运算单元,其它部分依照add.w复用即可。
使用Vivado IP核实现
乘法
最简单的方式为:
| |
Vivado中的综合工具遇到上面代码中的“*’’运算符时,会自动调用片上的DSP48(内含固化的16位乘法器电路)实现,最终实现的电路的时序通常不错,也几乎不消耗LUT资源,推荐大家使用。
也可以使用IP核Multiplier实现。
除法
使用Divider GeneratorIP核实现。
如何创建
首先找到Divider GeneratorIP核:
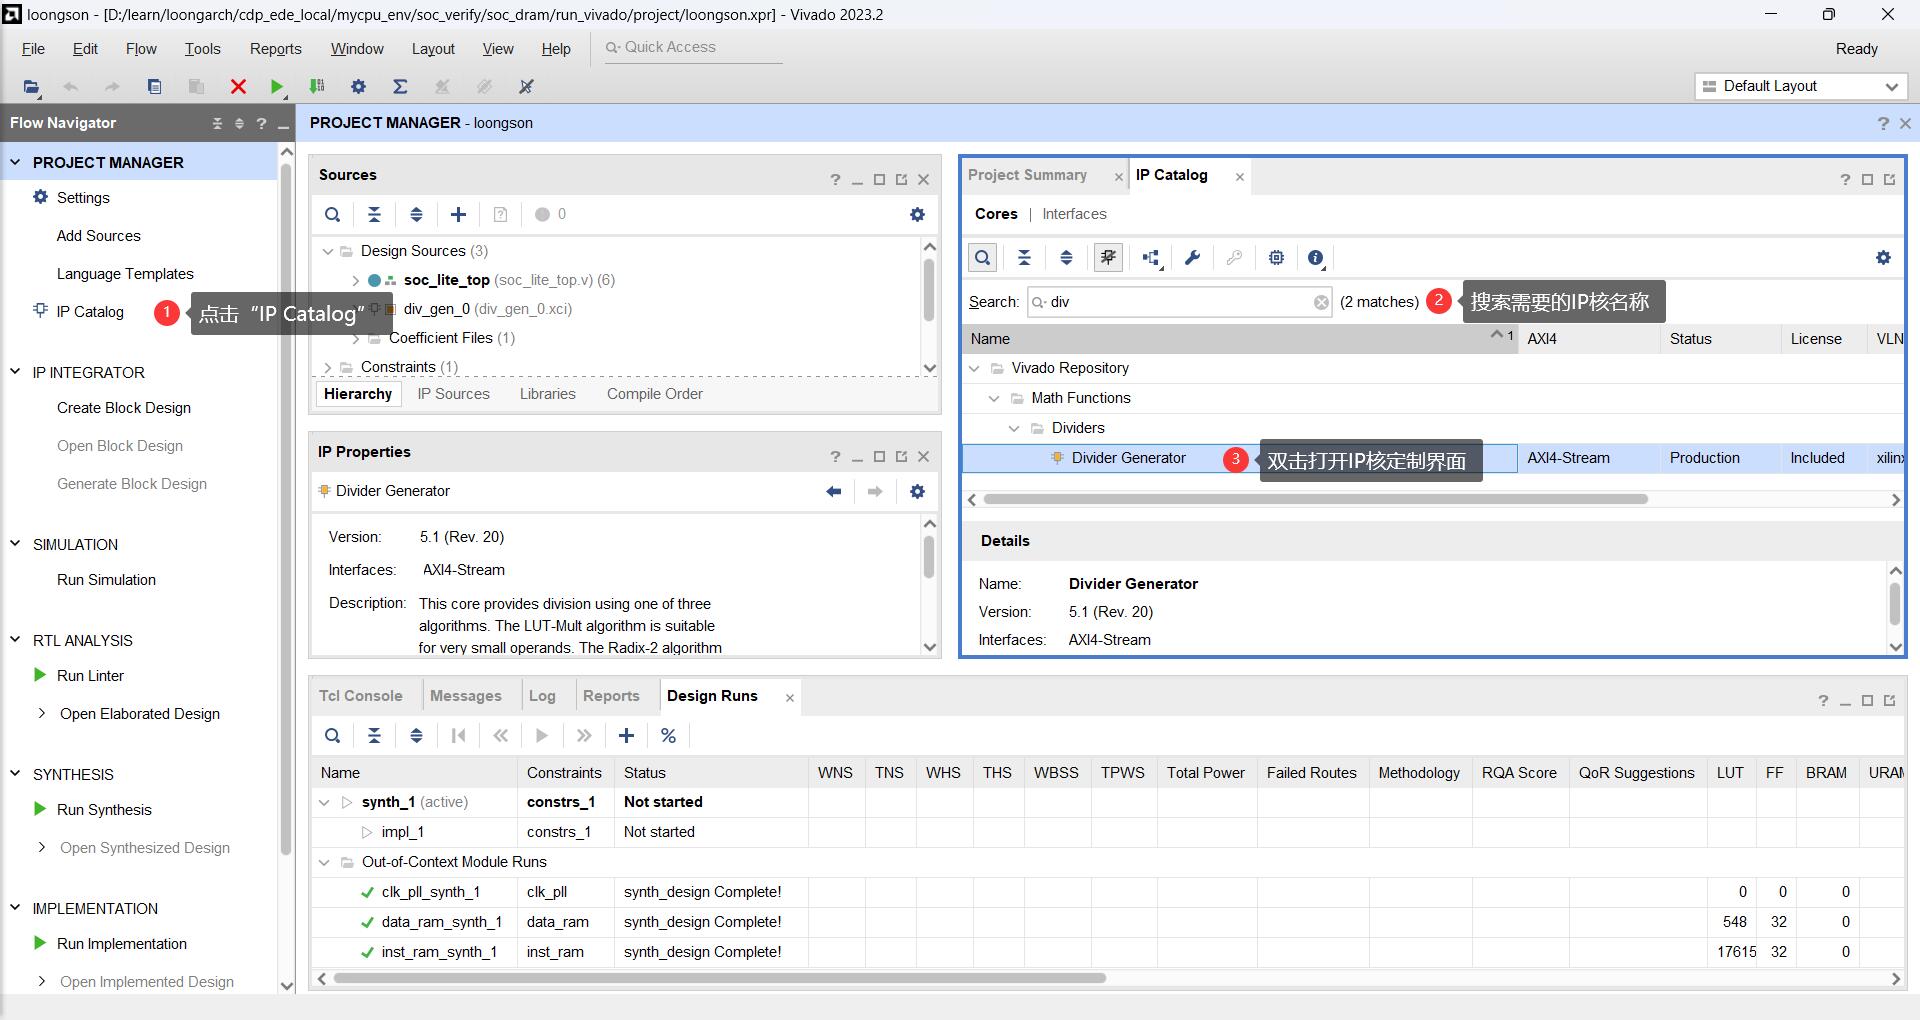
开始定制Divider GeneratorIP核:


开始建立IP核:

实例化IP核:
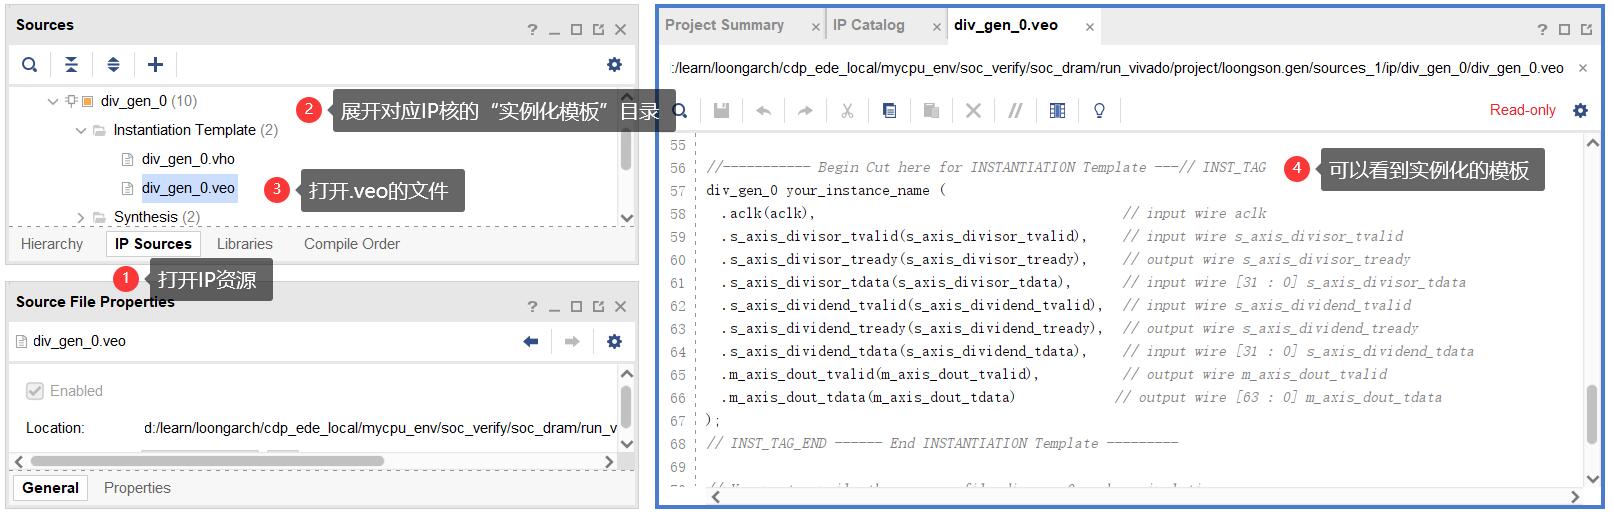
如何使用
目前Vivado中提供的除法器IP一定是AXI接口的,所以接下来我们对模块顶层信号及其工作方式进行基本介绍。
在定制IP核的界面中(可通过双击IP核的资源名称重新打开定制界面),左侧有接口信号图

总体上我们会看到时钟信号、被除数、除数通道以及输出(商和余数)通道。
对于被除数、除数通道,其有相同的信号组成
tdata信号为被除数、除数数据输入信号tready、tvalid为一对握手信号。tvalid是请求信号,tready是应答信号,在时钟上升沿到来时,如果tvalid和tready都等于1则视为成功的握手,发送方的数据写入接收方的缓存中
需要注意的是在握手成功后,一定要把
tvalid清0,如果再次握手成功的话将会被视为一个新的除法运算。
对于输出(商和余数)通道
tdata信号为商和余数数据输出信号,其中 [63:32] 位存放的是商,第 [31:0] 位存放的是余数tvalid信号为输出有效信号,高电平表示除法计算完成,tdata线上为计算结果
自行设计电路实现
注意到IP核中无论是乘法还是除法都只能固定计算有/无符号数,这样需要实例化两个运算单元分别进行运算,这样看起来非常浪费资源。我们可以采取一些措施将符号单独计算,全部转化为无符号数处理;也可以将32位的运算全部转化为33位有符号运算,只要根据有/无符号在第33位补充符号位/0即可。
exp11:转移指令和访存指令添加
目标:
- 熟悉CPU的数据通路
- 练习如何修改数据流动
- 练习如何添加指令
- 了解“地址对齐”
转移指令
需要添加的指令有blt、bge、bltu、bgeu,指令具体信息可参考我的LoongArch32r指令表。
相信经过exp10的分析,大家很快就能发现这些b指令都是换汤不换药(仅跳转条件判断不同)的一类指令,只要照着如beq指令的过程添加即可。
访存指令
需要添加的指令有ld.b、ld.h、ld.bu、ld.hu、st.b、st.h,指令具体信息可参考我的LoongArch32r指令表。
在看完手册后,我们发现普通访存指令的数据通路、控制逻辑都是相同的,区别仅在处理的数据位宽不同。
接下来让我们回忆一下我们的data_sram,它是一个宽度为32的Memory单元,每次读写的数据为32位。
当读回32位数据后,我们选择访存地址对应的字/半字/字节并按照有/无符号扩展到32位就是读取的数据;当需要写入时,我们将需要写入的字/半字/字节按照访存地址对应的位置填入32位数据的位置,并将字节写使能信号的对应位使能即可。
地址对齐
访存地址对应的位置即地址对齐,其有一定的规则,假设存储器中存储的数据如下图所示,每个字节中存储其所在字节地址
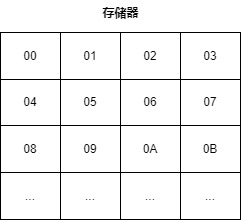
假如运行ld.w,访存地址为00B,则得到的数据为03020100H。(Loongarch采用小尾端的存储方式)
假如运行ld.h,存储器返回数据为03020100H
- 访存地址末尾为
00B,最终得到00000100H。 - 访存地址末尾为
10B,最终得到00000302H。
假如运行ld.b,存储器返回数据为03020100H
- 访存地址末尾为
00B,最终得到00000000H。 - 访存地址末尾为
01B,最终得到00000001H。 - 访存地址末尾为
10B,最终得到00000002H。 - 访存地址末尾为
11B,最终得到00000003H。
你应该会想问,剩下的情况呢?剩下的情况是不被允许的!剩下的情况被称为访存地址非自然对齐。
假如从地址01H处读取一个字(32bit),由于存储器的特性,我们需要先读取00H处的一个字,再读取04H处的一个字,再将它们的01H~04H处的数据拼接起来作为最终数据。实际上,读取一个字的数据对于CPU来说是非常费时间的(可能是上千个周期),更不用说读两个字了,所以我们在定义的时候就不允许这种跨字的数据读写(编译器分配地址空间时也会按照自然对齐地址分配)。
字节写使能
如果你不知道字节写使能是哪根线的话请重新看exp7的实践任务第2条
字节写使能即以字节为单位控制存储器写入的数据。
例如字节写使能为0011B,则地址为00B、01B处会写入新的数据,地址为10B、11B处数据不会被修改。
接下来让我们针对00H处的一个字的存储单元运行一段指令序列吧~
| 指令序号 | 指令 | 访存地址(B) | 数据(H) | 存储器数据(H) |
|---|---|---|---|---|
| 1 | st.w | 00 | 1234ABCD | 1234ABCD |
| 2 | ld.b | 01 | FFFFFFAB | 1234ABCD |
| 3 | st.h | 10 | 00009876 | 9876ABCD |
| 4 | ld.hu | 00 | 0000ABCD | 9876ABCD |
| 5 | st.b | 11 | 12345678 | 7876ABCD |
| 6 | ld.w | 01 | ERROR | 7876ABCD |
调试Tips
- 顶层信号中地址线
addr在接入存储器时将末两位截去,所以00B~11B的访存地址均会取出00H开始的一个字,详见soc_lite_top.v文件 - 大部分分支跳转指令本身的执行错误不会引发trace比对的ERROR,其后一条指令才会引发
- 当功能点越来越多,你可以尝试编译只有新指令的func程序来跳过前面已经pass的指令以提高仿真速度,但请最后跑一遍完整的func程序
exp12:添加系统调用异常支持
目标:
- 理解CPU中断例外的概念
- 学习精确异常处理的过程
- 在CPU中添加系统调用异常的支持
- 完全掌握exp11及以前的内容
特权指令
在计算机系统层次结构中,应用层在操作系统层之上,只能看到和使用指令系统的一个子集,即指令系统的用户态部分。每个应用程序都有自己的寄存器、内存空间以及可执行的指令。现代计算机的指令系统在用户态子集之外还定义了操作系统核心专用的特权态部分,我们称之为特权指令系统。
特权指令系统的存在主要是为了让计算机变得更好用、更安全。操作系统通过特权指令系统管理计算机,使得应用程序形成独占CPU的假象,并使应用间相互隔离,互不干扰。应用程序只能在操作系统划定的范围内执行,一旦超出就会被CPU切换成操作系统代码运行。
龙芯架构32位精简版中处理器核分为2个特权等级(PrivilegeLeVel,简称PLV),分别是PLV0和PLV3。处理器核当前处于哪个特权等级由CSR.CRMD中PLV域的值唯一确定。
所有特权等级中,PLV0是具有最高权限的特权等级,也是唯一可以使用特权指令并访问所有特权资源的特权等级。PLV3这个特权等级不能执行特权指令访问特权资源。对于Linux系统来说,架构中仅PLV0级可对应核心态,PLV3级对应用户态。
控制状态寄存器(CSR寄存器)
为了控制CPU的运行状态以及处理特权指令,有一组控制状态寄存器(在龙芯架构中称为CSR寄存器),其位于一个独立的地址空间。
| 名称 | 地址 | 描述 |
|---|---|---|
| CRMD | 0x0 | 当前模式信息 |
| PRMD | 0x1 | 例外前模式信息 |
| ESTAT | 0x5 | 例外状态 |
| ERA | 0x6 | 例外返回地址 |
| EENTRY | 0xc | 例外入口地址 |
| SAVE0~SAVE3 | 0x30~0x33 | 数据保存 |
完整CSR寄存器表和各个CSR寄存器的定义详见原手册第7节。
CSR寄存器有其专用的读写指令csrrd、csrwr、csrxchg,注意这些指令仅在核心态(即PLV0)可运行。
异常和中断
计算机通常按照软件的执行流进行顺序执行和跳转,但有时会需要中断正常的执行流程去处理其他任务,可以触发这一过程的事件统称为异常。
中断通常由CPU核外部事件发起,CPU核响应后暂停原先程序执行另一段程序的事件。从CPU角度看,中断也可以被视为一种特定的异常,接下来将不做区分统一以“异常”表达。
顾名思义,“异常”不是常态。异常对应的情况发生的频度不高,但处理起来比较复杂。本着“好钢用在刀刃上”的设计原则,我们希望尽可能由软件程序而不是硬件逻辑来处理这些复杂的异常情况。这样做既能保证硬件的设计复杂度得到控制又能确保系统的实际运行性能没有太大的损失。
异常处理绝大部分交给异常处理程序完成,但是在处理的开始和结束仍需硬件完成。
预备阶段
响应准备阶段
- CPU确认自身可以响应异常处理。
- 记录被异常打断的指令的地址到
CSR.ERA - 记录当前运行状态(
CSR.CRMD的PLV、IE)到CSR.PRMD的对应域。 - 同时调整CPU的权限等级(通常调整至最高特权等级
CSR.CRMD.PLV=0)并关闭中断响应(CSR.CRMD.IE=0)。
响应阶段
- 根据例外优先级(见原手册6.2.2节)选择响应最高优先级的异常,将对应的异常编码写入
CSR.ESTAT的Ecode和Esubcode。 - 跳转至例外入口(来自
CSR.EENTRY)。
结束阶段
- 异常处理程序结束后会执行
ertn指令,其指示CPU从例外处理状态返回。 - 例外前运行状态(
CSR.PRMD的PLV、IE)被写回CSR.CRMD的对应域。 - 跳转到被异常打断的指令的地址
CSR.ERA处取指。
精确异常
走完异常处理的全部流程,如果我们从原程序流的角度“看”,那么我们会发现它根本不知道某个时刻CPU被“借走”处理了另一段程序,这就是所谓的精确异常。
简单的来说精确异常要求在处理异常时,发生异常的指令前面的所有指令都执行完(修改了机器状态),而发生异常的指令及其后面的指令都没有执行(没有修改机器状态)。
在流水线处理器中,同时会有多条指令处于不同阶段,不同阶段都有发生异常的可能,那么如何实现精确异常呢?书中给出一种可行的设计方案:
- 任何一级流水发生异常时,在流水线中记录下发生异常的事件,直到写回阶段再处理。
- 如果在执行阶段要修改机器状态(如状态寄存器),保存下来直到写回阶段再修改。
- 指令的PC值随指令流水前进到写回阶段为异常处理专用。
- 将外部中断作为取指的异常处理。
- 指定一个通用寄存器(或一个专用寄存器)为异常处理时保存PC值专用。
- 当发生异常的指令处在写回阶段时,保存该指令的PC及必需的其他状态,置取指的PC值为异常处理程序入口地址。
调试Tips
- 异常处理需要复杂的控制系统支持,添加起来有一定难度。
但它对CPU意味着可以在考试中途出去上个厕所回来接着做而非必须一口气做到底 - 如果觉得直接在流水线上改动的不熟练的话,或许可以在单周期CPU上先添加一下,然后再切分到流水线的各个级。
如果你有做好git版本控制的话应该很好找吧 - 某些CSR寄存器和PC寄存器一样存在特定的复位值,见原手册6.3节。
- 对于CSR寄存器,其也和通用寄存器一样存在冒险问题等待解决。
- 在
CSR.ESTAT.IS域,其第10位在有些func程序中固定为0,有些开放读写,可能需要注意下。 - 例外返回的地址不一定是
CSR.ERA中的地址。在本实验中返回原地址将会重新执行syscall。是死循环捏
exp13:添加其它异常支持
目标:
- 完善
ADEF、ALE、BRK、INE异常支持 - 添加中断支持
- 添加定时器、计时器
在exp12完成了syscall的异常支持后,我想CPU中完整的异常处理的数据和控制通路已经搭建完成了,添加新的异常支持只需要针对新的异常进行对应的判断,发出对应的异常消息即可。
中断
中断可被视为一种特定的异常,但是其与其它异常有着一个关键的不同点。
由于中断通常由CPU核外部事件触发,其相对CPU核是异步的,所以发出的中断信号需要保持到被CPU采样,否则将永远无法触发中断异常。当然这是由中断源负责维护的。
在较为简单的线中断模式下,硬件仅需每拍采样各个中断源并将其状态记录于CSR.ESTAT.IS域中,并在认为有需要响应的中断时将中断例外标注至流水线中的某一条指令上,随后的过程与其它例外相同。
定时器与定时器中断
在龙芯32位精简版架构中定义了一个定时器,其随着时钟自减,直到为零时置起定时器中断信号。
详细定义及运行控制信息见原手册的TCFG、TVAL、TICLR寄存器定义(7.6.2~7.6.4)。
计时器
龙芯架构 32 位精简版定义了一个恒定频率计时器,其主体是一个 64 位的计数器,称为 Stable Counter。Stable Counter 在复位后置为 0,随后每个计数时钟周期自增 1,当计数至全 1 时自动绕回至 0 继续自增。同时每个计时器都有一个软件可配置的全局唯一编号,称为 Counter ID,保存在CSR.TID寄存器中。
调试Tips
- 在经过了exp12的锤炼后,本实验应该不难了吧~~\doge~~
- 在verilog描述中注意多驱动问题。如果你选择给每个CSR寄存器一个always块负责内容修改的话,请注意这个CSR寄存器中所有数据更新都必须在这个always块中,以避免多驱动问题产生。例如
CSR.ESTAT.IS[11]的定时器中断状态位的赋值不能在CSR.TVAL寄存器中,当然还有其它情况,请自行注意避免。(可以在综合的警告或者Linter语法检查找到已有的多驱动) - 选择你觉得舒服的CSR寄存器声明方式,可以按照名字定义32位的,也可以直接按照子域分开定义……善用宏定义将位索引转换为有意义的单词
exp14:添加类SRAM总线支持
目标:
- 学习总线的原理及作用
- 在CPU中添加简单的类SRAM接口总线支持
总线
总线的本质作用是完成数据交换。总线用于将两个或两个以上的部件连接起来,使得它们之间可以进行数据交换,或者说通信。
总线的具体介绍可见《计算机体系结构》。
在总线通信中,通常将读写操作发起方称为主方(master),响应方称为从方(slave)。每一次读写操作的过程可大致分为:请求发起、响应请求、请求数据传输、请求数据返回。和我们之前的实验中不同的是,由于实际情况下总线上可能不止处理一件事物、数据的读写也需要一定的时间,所以每个步骤之间是有不确定的时间间隔的。为了明确何时的数据是有效的,每次有效的数据传输都基于握手信号,只有握手成功才会传输有效数据。
类SRAM接口
我们的CPU最终需要实现AMBA AXI总线接口,但是直接上手AXI总线可能有些困难,所以我们先学习类SRAM接口,或者说在我们原先的SRAM接口上加入握手机制,其接口信号如下:
| 信号名称 | 位宽 | 方向 | 功能 |
|---|---|---|---|
| req | 1 | master->slave | 读写请求信号 |
| wr | 1 | master->slave | 高电平表示写请求,低电平为读操作 |
| size | 2 | master->slave | 传输字节数 |
| addr | 32 | master->slave | 请求的地址 |
| wstrb | 4 | master->slave | 写请求的写字节使能 |
| wdata | 32 | master->slave | 写请求的写数据 |
| addr_ok | 1 | slave->master | 请求的地址传输完毕 |
| data_ok | 1 | slave->master | 请求的数据传输完毕(读取的数据or数据的写入) |
| rdata | 32 | slave->master | 读请求返回的读数据 |
相较于原先的SRAM接口,我们只添加了size、addr_ok、data_ok三根信号线,接下来我们解释一下这三条线的作用。
size
size信号表示该次请求传输的字节数,根据访存指令不同选择不同的值
- 0: 1字节。
ld.b、ld.ub、st.b - 1: 2字节。
ld.h、ld.uh、st.h - 2: 4字节。
ld.w、st.w
addr_ok
addr_ok信号用于和req信号一起完成读写请求的握手。只有在clk的上升沿同时看到req和addr_ok为1的时候才是一次成功的请求握手,读写请求、读写地址和可能的写数据被发送至从方。
data_ok
data_ok信号有双重身份。对应读事务的时候它是数据返回的有效信号;对应写事务的时候,它是写入完成的有效信号。
在类SRAM接口中主方对于数据响应总是可以接收,所以不再设置Master接收data_ok的握手信号。也就是说如果存在未返回数据响应的请求,则在clk的上升沿看到data_ok为1就可以认为是—次成功的数据响应握手。
读写时序
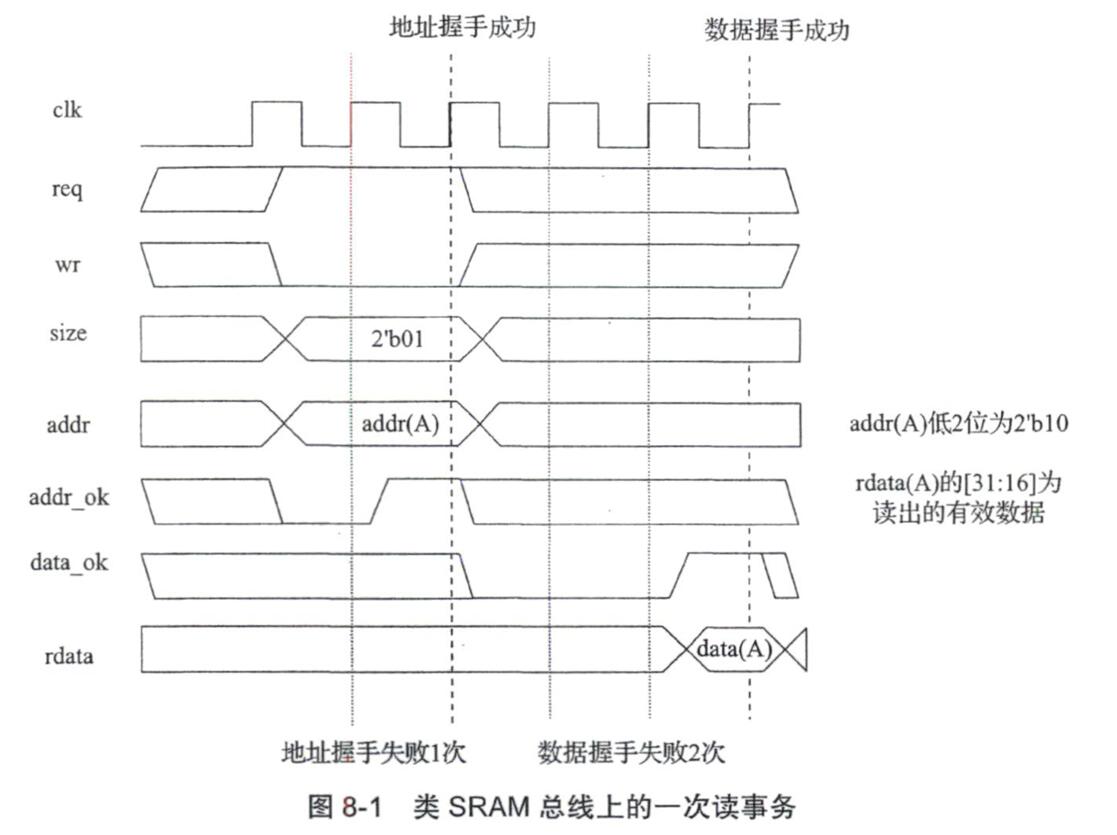
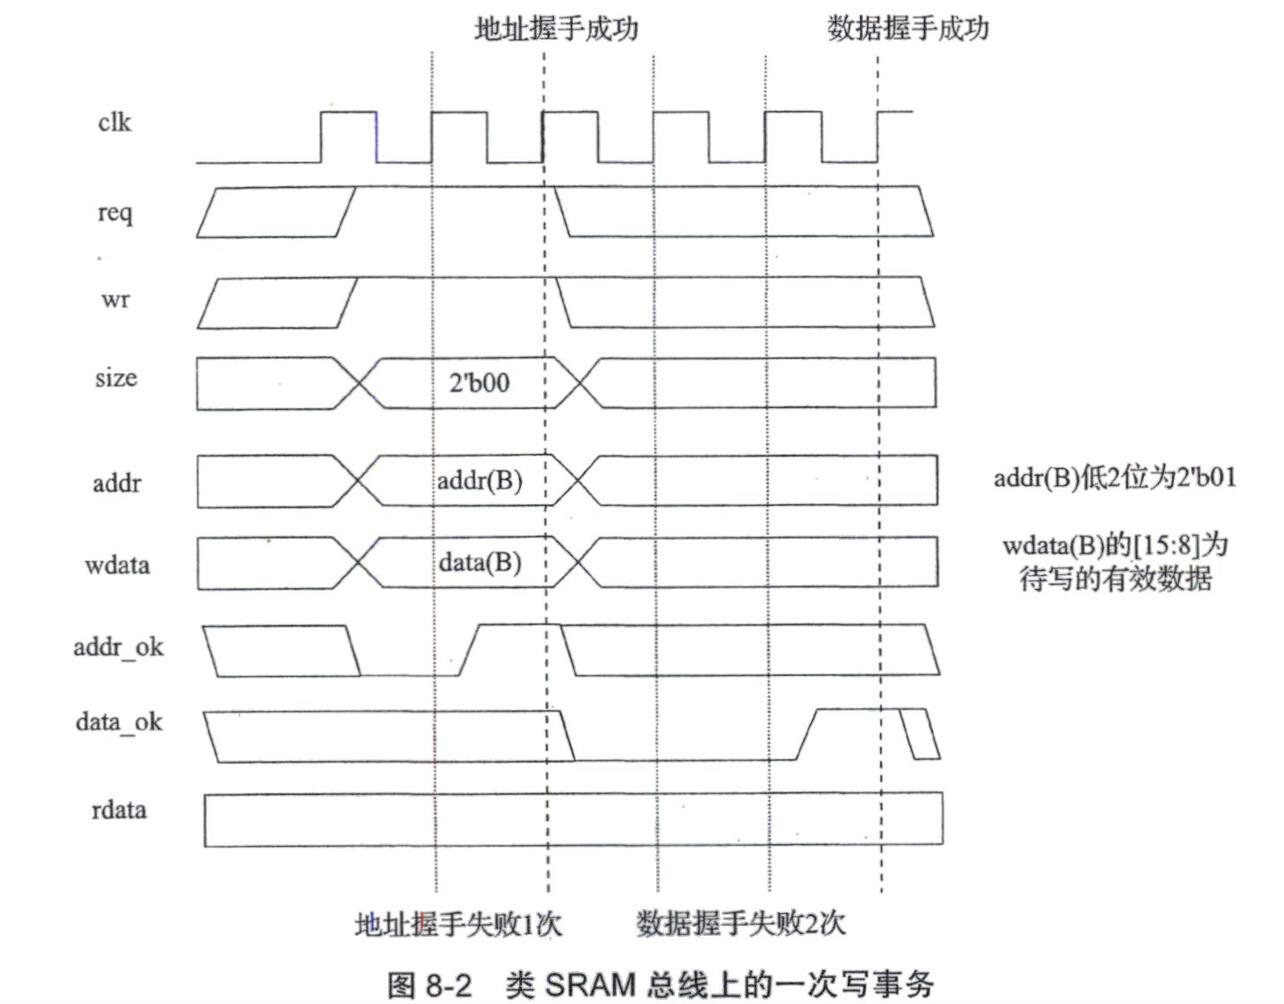
需要注意的是,总线上支持多事务处理,比如说以下连续写读操作:
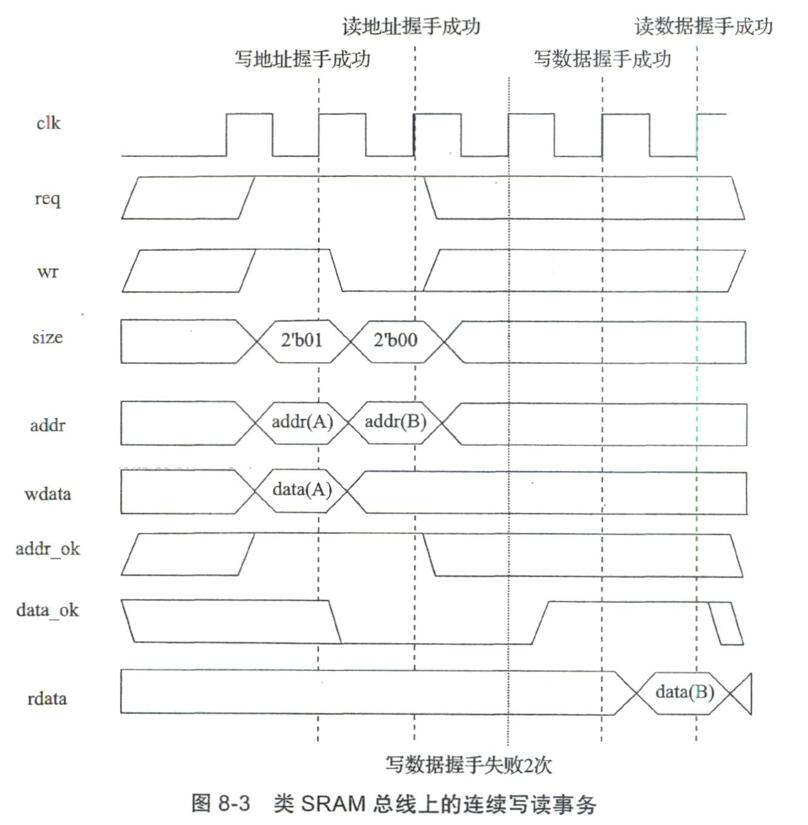
对于初学者来说还是先一个一个事务处理,多事务会复杂上不少,对于我们的单发射流水线也起不到很大优化效果。
建议阅读一下《CPU设计实战》中“类SRAM总线的设计”一节,书中有详细的分析。如果没有Loongarch版的话MIPS版也是相通的。
调试Tips
- 从总线接口开始,你就会发现何为时序逻辑比组合逻辑难了。不出意外的话你应该会开始遇到各种差一拍或者其它奇奇怪怪的情况,请记得此时你的流水级处理的事情不像之前那样只有一拍,而变成类似一个状态机一样的多周期流水级,需要对流入和流出的控制有着明确的信号逻辑。
- 明确需要当拍更新(组合逻辑)和下拍更新(时序逻辑)的信号及它们间的相互依赖。
exp15、16:添加AXI总线支持、完成AXI随机延迟验证
CPU对外只有一个AXI接口,需在内部完成取指和数据访问的仲裁。推荐在本任务中实现一个类SRAM-AXI的2x1的转接桥,然后拼接上exp14完成的类SRAM接口的CPU,将myCPU封装为AXI接口。
AXI接口
备注栏中是我们针对exp给出的—些设计建议。
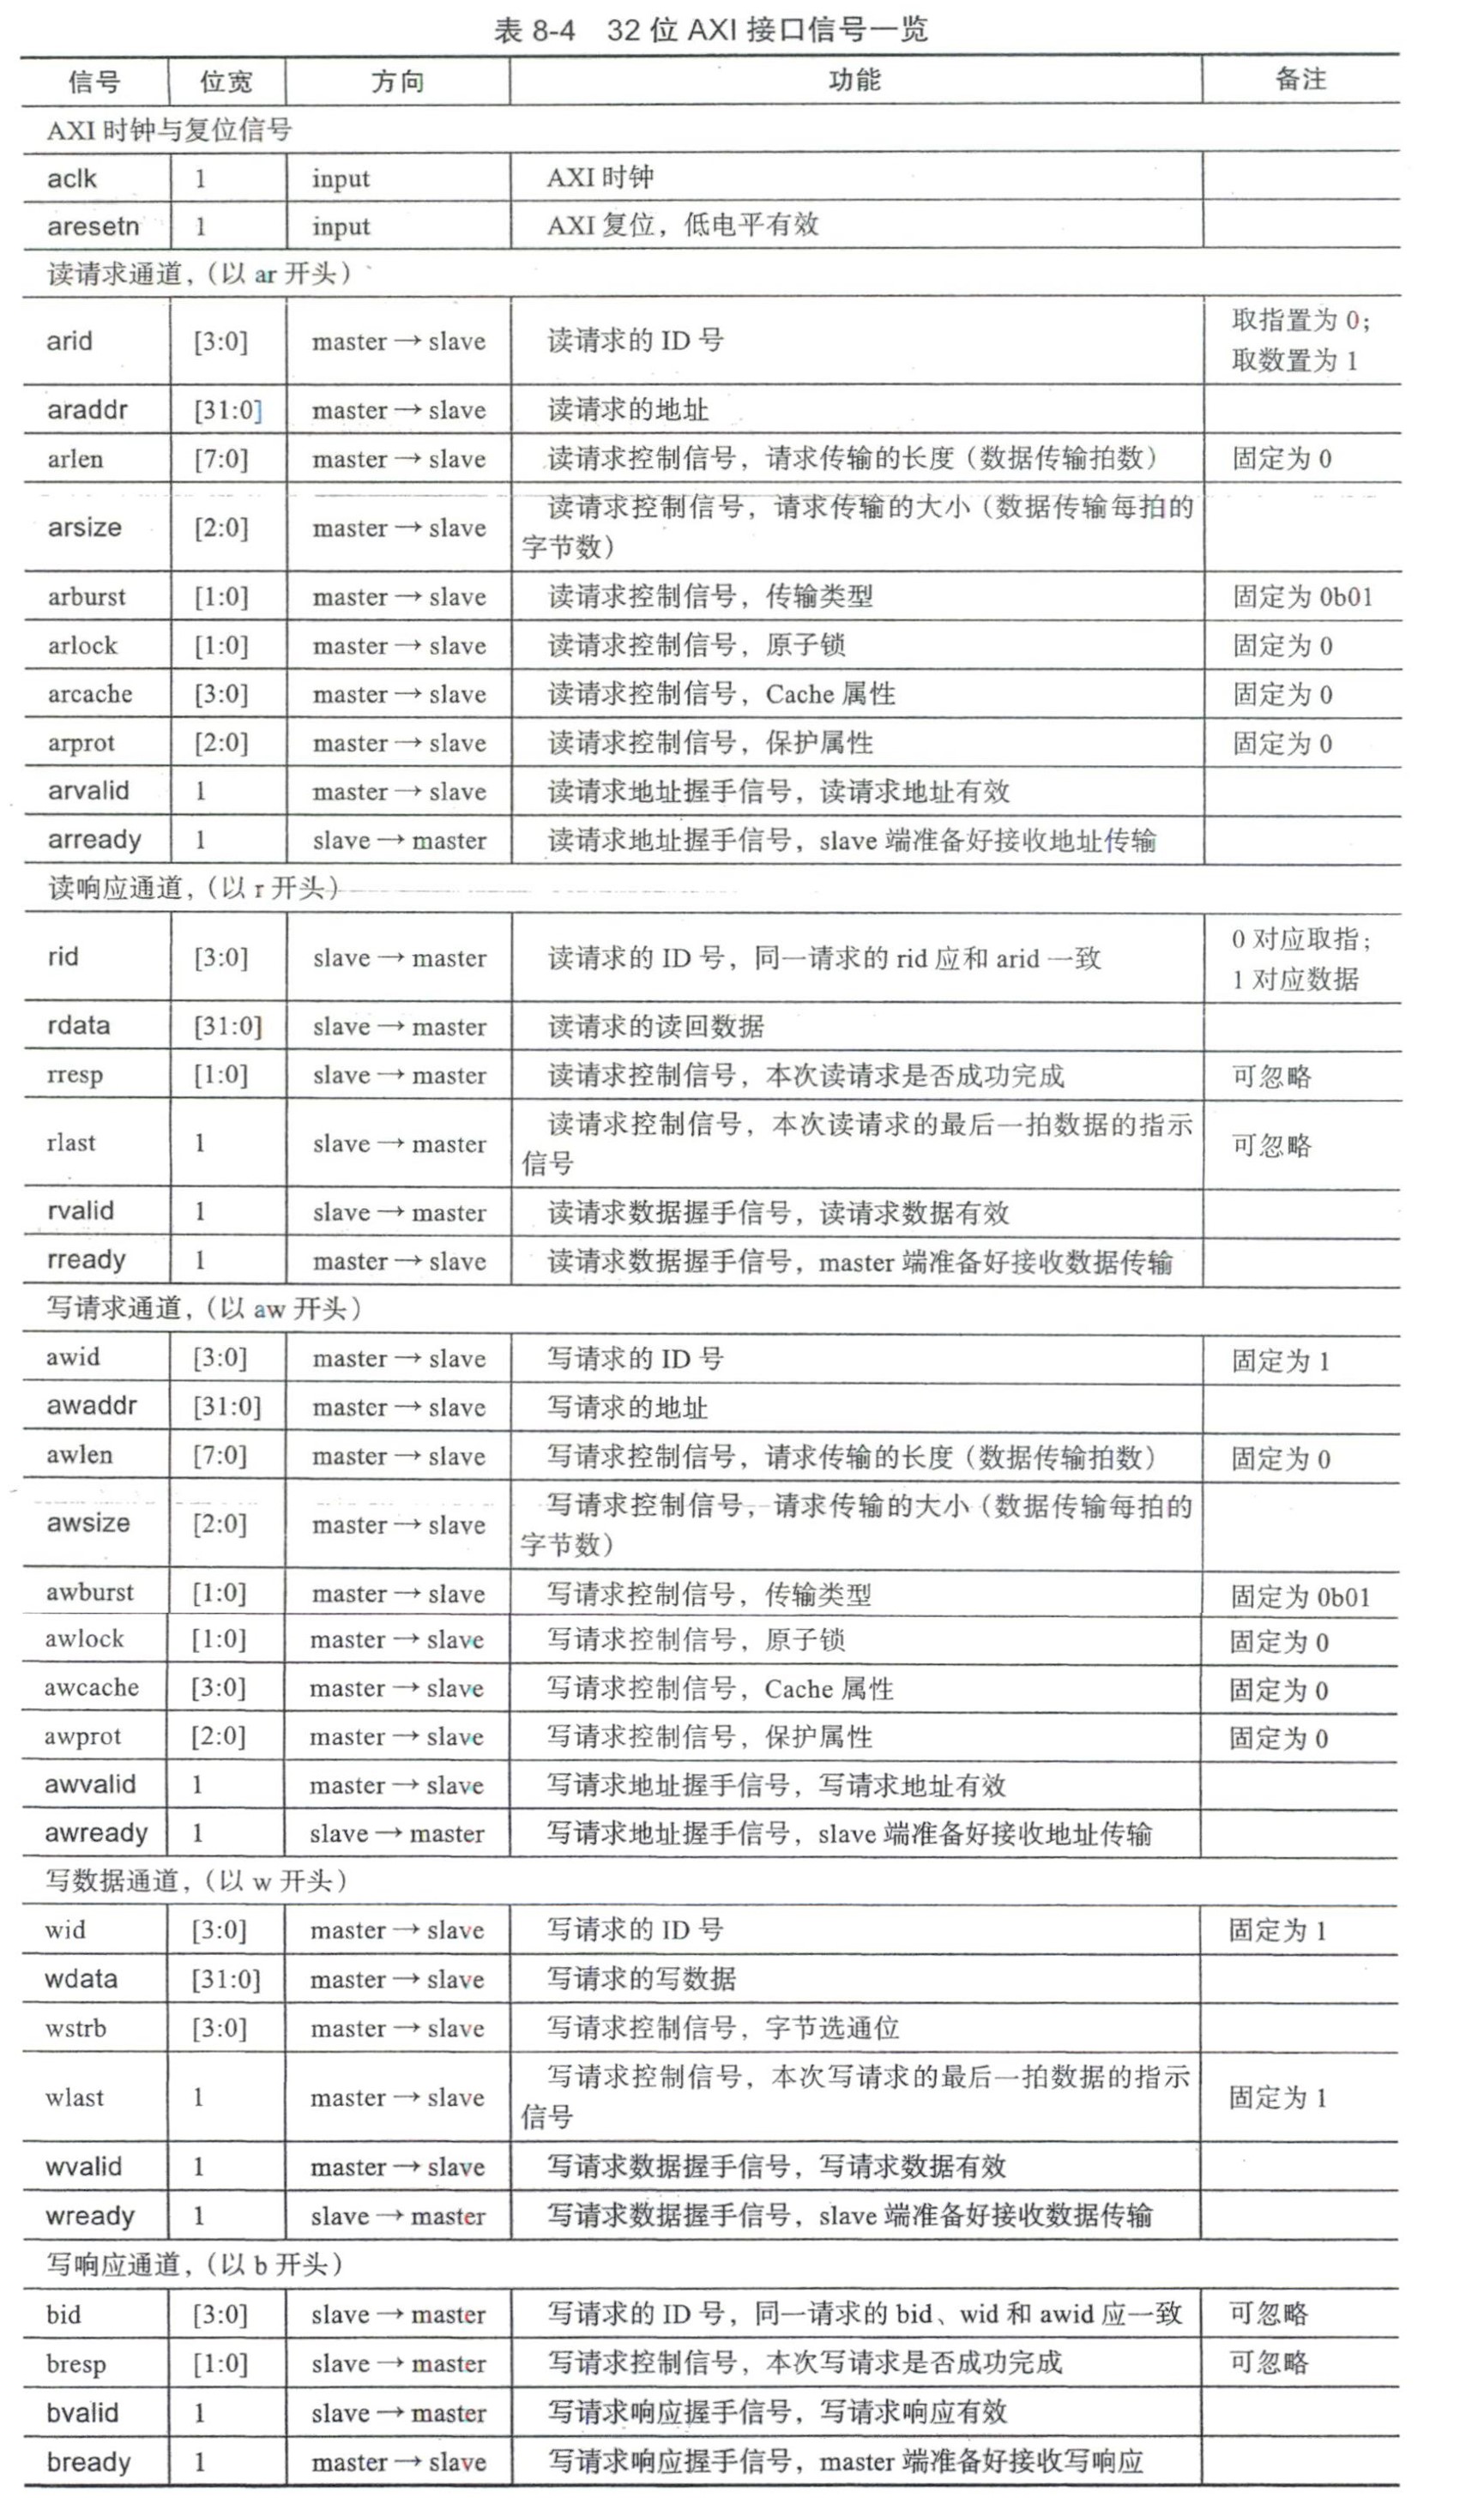
AXI接口的设计资料比较多,《CPU设计实战》和《计算机体系结构基础》以及网络上都有十分详细的分析和教学,我就不班门弄斧了。
在这里提供一个转接桥参考。
调试Tips
- 到这里提前恭喜你已经写出完整的CPU (◆゜∀゜)👍
- 在exp16实践任务中第6、7步比较费时间,建议各个种类各挑一个就行
- 到这我也没什么Tips可写了,靠各位自己STFW啦*(^_^)/*
exp17:TLB模块设计
在介绍TLB模块之前,让我们先来学习一下计算机中存储管理。
存储管理
处理器的存储管理部件(Memory Management Unit,简称MMU)支持虚实地址转换、多进程空间等功能,是通用处理器体现“通用性”的重要单元,也是处理器和操作系统交互最紧密的部分。
这一部分的内容量比较大,细节比较多,但是原理其实很简单,就是送快递用到的地址。让我们先从虚实地址开始解释。
在之前的CPU设计中,我们只实现了最简单的直接地址翻译模式,即直接用PC中的地址或者计算出的地址作为访存地址,在存储器中读写数据,但对于32位的处理器,只能寻址全0到全1的$2^{32}=4\mathrm{GB}$地址空间。显然,现代计算机中存储空间早远远超过4GB大小了,所以我们需要一个方式进行更大地址空间的寻址,而虚地址就诞生了。
仅提供一个简单的引入,虚地址的意义不仅如此。
在虚实地址转换模式下,处理器核提供的地址是虚拟地址,经过MMU转换成物理地址后才发送给存储器进行数据读写。类比一下,在你想去泰山路143号的时候,你会首先在地图上搜索泰山路143号这个地址所在的地理位置,然后你就知道怎么去了。
页式存储管理是一种常见而高效的方式,操作系统将内存空间分为若干个固定大小的页,并维护虚拟页地址和物理页地址的映射关系(即页表)。页就类似“泰山路”,“143号”则称为页内偏移。
由于完整的页表通常非常大,只能放在物理存储器中,同时查询时间消耗也很长,再加上物理存储器的访问本身就很费时间,所以为了加速地址转换,转换后备缓冲器(Translation Lookaside Buffer,TLB)将最常用的页表项缓存用来跳过查询的时间。
TLB结构
LoongArch指令系统下TLB分为两个部分,一个是所有表项的页大小相同的单一页大小TLB(Singular-Page-Size TLB,简称STLB),另一个是支持不同表项的页大小可以不同的多重页大小TLB(Multiple-Page-Size TLB,简称MTLB)。STLB的页大小可通过STLBPS控制寄存器进行配置。
龙芯架构32位精简版只支持4KB和4MB两种固定页大小,以4KB页大小为例,虚地址的[31:12]位作为页表查询信息,[11:0]位作为页内偏移,满足$2^{页内偏移位数}=页大小$。
接下来介绍页表项的构成:

页表项的比较部分包括:
- VPPN表示虚双页号。 在龙芯架构32位精简版中,每一个页表项存放了相邻的一对奇偶相邻页表信息,所以TLB页表项中存放虚页号的是系统中虚页号/2的内容,即虚页号的最低位不需要存放在TLB中。查找TLB时在根据被查找虚页号的最低位决定是选择奇数号页还是偶数号页的物理转换信息。
路名,奇偶相邻可视作路两侧的单双号,但在物理存储器中不一定相邻 - PS表示页大小。 仅在MTLB中出现。用于指定该页表项中存放的页大小。数值是页大小的2的幂指数。龙芯架构32位精简版只支持4KB和4MB两种页大小,对应TLB表项中的PS值分别是12和211。
每条路支持最大的号牌数 - G表示全局域标识。 为1时关闭ASID匹配,表示该TLB表项适用于所有的地址空间。
- ASID表示地址空间标识。 标记该TLB表项属于哪个地址空间,只有CPU中当前的ASID(由CSR.ASID的ASID域决定)与该域相同时才能命中,ASID用于区分不同进程的页表,操作系统为每个进程分配唯一的ASID。
可认为是城市名 - E表示有效性。 E为0的项在进行TLB查找时将被视为无效项。
表项的物理转换部分存有一对奇偶相邻页表的物理转换信息,每一个页的转换信息包括:
- PPN为物理页号。
- PLV表示该页表项对应的权限等级。 该页表项可以被任何特权等级不低于PLV的程序访问。
- MAT表示存储访问类型。 控制落在该页表项所在地址空间上的访存操作的存储访问类型,如是否可通过Cache缓存等。
- D被称为“脏”(Dirty)位。 为1表示该页表项所对应的地址范围内已有脏数据(修改过的数据)。
- V为有效位。 为1表明该页表项是有效且被访问过的。
TLB设计分析
TLB模块类似通用寄存器模块,需要支持页表项读写(TLBWR、TLBRD、TLBFILL指令)、查询(TLBSRCH指令和地址转换)、无效化(INVTLB指令)。
为了使流水线能够满负荷运转不断流,TLB模块要能够支持取指和访存同时进行查找,这意味着查找端口应该有两套,或者有两个TLB模块。
TLB模块部分参考代码见附录TLB模块参考,注意多驱动问题。
exp18:添加TLB相关指令和CSR寄存器
TLB虚实地址翻译过程
用TLB进行虚实地址翻译时,首先要进行TLB查找,将待查虚地址vaddr和CSR.ASID中ASID域的值asid一起与TLB中每一项的指定索引位置项进行比对。
- 如果TLB表项的E位为1,且vaddr对应的虚双页号vppn与TLB表项的VPPN相等(该比较需要根据TLB表项对应的页大小,只比较地址中属于虚页号的部分),且TLB表项中的G位为1或者asid与TLB表项的ASID域的值相等,那么TLB查找命中该TLB表项。
- 如果没有命中项,则触发TLB重填异常(TLBR)。
如果查找到一个命中项(多项命中处理器运行情况不确定),那么根据命中项的页大小和待查虚地址确定vaddr具体落在双页中的哪一页,从奇偶两个页表项取出对应页表项作为命中页表项。
如果命中页表项的V等于0,说明该页表项无效,将触发页无效异常,具体将根据访问类型触发对应的load操作页无效异常(PIL)、store操作页无效异常(PIS)或取指操作页无效异常(PIF)。
如果命中页表项的V值等于1,但是访问的权限等级不合规,将触发页权限等级不合规异常(PPI)。权限等级不合规体现为,CSR.CRMD中PLV域的值大于命中页表项中的PLV值。
如果上述检查都合规,还要进一步根据访问类型进行检查。
- 如果是一个store操作,但是命中页表项中的D值等于0,将触发页修改异常(PME)。
如果找到了命中项且经检查上述异常都没有触发,那么命中项中的PPN值和MAT值将被取出,前者用于和vaddr中提取的页内偏移拼合成物理地址paddr,后者用于控制该访问操作的内存访问类型属性。
内存访问类型属性将在后文添加Cache时介绍,这里暂时忽略它即可。本exp中也无需关心异常,仅将命中的数据通路打通即可。
TLB相关CSR寄存器
本exp中需要添加TLBIDX、TLBEHI、TLBELO0、TLBELO1、ASID、TLBRENTRY共6个CSR寄存器,定义见原手册第7.5节。
TLB维护指令
定义见原手册第4.2.3节。
exp19:添加TLB相关例外支持
TLB相关例外
根据各种TLB相关例外触发条件添加对应异常申请即可。
当触发TLB重填异常时,除了更新CSR.CRMD外,CSR.CRMD中PLV、IE域的旧值将被记录到CSR.TLBRPRMD的相关域中,异常返回地址也将被记录到CSR.TLBRERA的PC域中,处理器还会将引发该异常的访存虚地址填入CSR.TLBRBAV的VAddr域并从该虚地址中提取虚双页号填入CSR.TLBREHI的VPPN域。当触发非TLB重填异常的其他TLB类异常时,除了像普通异常发生时一样更新CRMD、PRMD和ERA这些控制状态寄存器的相关域外,处理器还会将引发该异常的访存虚地址填入CSR.BADV的VAddr域并从该虚地址中提取虚双页号填入CSR.TLBEHI的VPPN域。
TLB相关CSR寄存器
本exp中需要添加DMW0~1两个直接映射配置窗口CSR寄存器,其作用如下
当处理器核的MMU处于映射地址模式时,还可以通过直接映射配置窗口机制完成虚实地址的直接映射。直接映射配置窗口共设置有两个,可同时用于取指和load/store操作。在龙芯架构32位精简版中,每一个直接映射配置窗口可以配置一个$2^{29}$字节固定大小的虚拟地址空间。当虚地址命中某个有效的直接映射配置窗口时,其物理地址直接等于虚地址的[28:0]位拼接上该映射窗口所配置的物理地址高位。命中的判断方式是:虚地址的最高3位([31:29]位)与配置窗口寄存器中的[31:29] 相等,且当前特权等级在该配置窗口中被允许。
举例来说,通过将DMW0配置为0x80000011,那么在PLV0级下,0x80000000~0x9FFFFFFF这段地址将直接被映射到物理地址空间0x0~0x1FFFFFFF上,其存储访问类型是一致可缓存2的。
另外,在实验中未提及,但是在指令手册中有的CSR寄存器(如PGD)可自行添加,完整的CSR寄存器才能支持完整的功能。这里简单介绍一下PGDL和PGDH的作用。
现代处理器都是支持多线程的。对于每个线程来说,其都有一块独立的地址空间,当一个新进程被创建时,操作系统会为其分配一个新的用户空间PGD(Page Global Directory)。当进程切换时,PGD表也需要进行更换,此时仅需更改PGDL或PGDH中的地址并刷新TLB即可。
在《计算机体系结构基础》中写到 “每个进程的PGD表基地址放在进程上下文中,内核进程进行切换时把PGD表的基地址写到CSR.PGDH的Base域中,用户进程进行切换时把PGD表的基地址写到CSR.PGDL的Base域中。”
exp20:Cache模块设计
目标:
- 熟悉类SRAM接口和AXI总线的握手机制
- 理解Cache的地址划分、命中判断和替换过程
- 实现两路组相联、写回写分配的Cache模块
- 通过Cache模块级验证
为什么需要Cache
回想一下exp16,当AXI总线加入随机延迟后,由于总线总是慢于CPU本身的,CPU一直处在等待取指或者访存结果空跑的状态中。这就是访存墙,即运算已经完成了,数据却还堵在路上,算力再高也没用。
一个直观的想法是:把最近用过的数据放到CPU附近,下次用到的时候就不用再去内存找了。 这就是Cache最基本的作用,加快访存速度。由于程序经常会重复访问某些地址,例如循环中的指令;也经常访问相邻地址,例如顺序执行的指令和数组中的元素,读指令常常在一小块或者几小块中反复执行,这使得我们使用一块小而快的cache做中转加速变得可能。以上两种特点分别称为时间局部性和空间局部性。。
至于为什么不弄大点全缓存了,那当然是——贵。。所以Cache不可能把所有内存都装进去,所以我们接下来需要解决三个问题:数据放在哪里、怎么知道数据在不在、放不下时丢掉谁。
地址划分
本实验中,每个Cache存放8KB数据、采用两路组相联、每个Cache行16字节。我们自己算一下:
$$ 组数=\frac{8\mathrm{KB}}{2\times16\mathrm{B}}=256 $$也就是说,每个Cache有256组,每组可以放两个Cache行;每行又可以放4个32位的字。由此得到32位地址的划分:
| |
- Index决定去第几组找数据。
- Tag用来确认这组里的数据是不是我们要找的那一行。
- Offset决定访问行中的哪个位置,其中
[3:2]选字,[1:0]配合字节读写处理。
举例来说,地址0x12345678对应Tag为0x12345、Index为0x67、Offset为0x8,它所在Cache行的起始地址是0x12345670。
从表格到RAM
先把每一路Cache看作一张有256项的表,每项记录如下信息:
| 信息 | 位宽 | 作用 |
|---|---|---|
| Tag | 20 | 记录这一行的地址标签 |
| V | 1 | 表示这一行是否有效 |
| D | 1 | 表示数据是否被修改、需要写回 |
| Data | 128 | 保存16字节数据 |
这里的D是Cache行的脏位,表示Cache里的数据可能比内存中的新(被修改过)。不要和TLB中的D混淆,TLB的D参与判断是否允许写入该页,两者不是一根信号。
实际实现时,我们可以把Tag和V拼成一个21位的RAM;把Data拆为4个32位的Bank,分别保存行中的第0、1、2、3个字;D则用寄存器实现。这样每一路需要1个TAGV RAM和4个DATA Bank RAM,两路共需要10个RAM。
这里拆Bank的作用是与总线宽度对齐,一次普通load/store最多只操作其中一个字,而替换时又需要读出整行。拆分之后就可以分别控制各个字的读写,也方便支持st.b、st.h指令。
RAM配置时需要注意:
- TAGV RAM为
256×21,DATA Bank RAM为256×32,使用同步读、单端口RAM。 - DATA Bank RAM要开启字节写使能,复用exp11中已经处理好的
wstrb和写数据。 - 按手册的单周期读延迟配置,不要勾选额外的
Primitives Output Register、Core Output Register。多出来的一拍会让请求和RAM输出错位。(也可以自行设计两拍缓冲的)
命中与缺失
对于最简单的读请求。第一拍接收地址,把Index送到两路RAM,同时把本次请求的Tag、Offset等信息存入Request Buffer。下一拍RAM返回数据,再拿返回的Tag和寄存下来的请求Tag比较:
| |
命中之后,按请求的Offset选出对应的32位数据返回即可。
为什么一定要寄存请求? 因为CPU可能已经把下一条请求放到输入端口上了。如果用当前端口的Tag和上一拍读出的Tag比较,就相当于拿着张三的快递单去领李四的包裹。
没有命中时,需要保存原请求、选定替换路,再从内存读回所需的整行。可以优先选择V为0的路;两路都有效时再使用伪随机数选择。替换路一旦选定就要存下来,不能让它跟着每拍变化的随机数跑。
写回与写分配
接下来考虑store,本实验采用写回、写分配策略:
- 写回(Write Back):写命中时只更新Cache并将D置1,等这一行被替换时再写回内存。
- 写分配(Write Allocate):写缺失时,先从内存取回整行,再把本次store的数据覆盖到对应位置。
为什么写一个字还要读一整行?因为Cache里还需要保存同一行中其余字节的正确内容,不能凭空把它们变成0。
对于需要被替换的旧行,只有V && D成立才需要写回。写回和重填的地址分别是:
| |
这两个地址非常容易写混。被替换的行和新请求只是Index相同,Tag往往完全不同。如果写回时用了新请求的Tag,就会把旧数据写到新地址上。
store miss重填时,仅在返回字编号等于请求的Offset[3:2]时合并写数据,其余字直接使用内存返回值。下面是目标字按字节合并的示意:
| |
这里的req_wdata已经按exp11的方法放到了正确的字节通道上,不要在Cache里再移位一次。重填完成后,读缺失得到的行D置0,写缺失得到的行D置1。
状态机与缓冲
Cache可以按照“接收请求—查找—处理缺失—重填”的顺序组织状态机。书中的主状态机有IDLE、LOOKUP、MISS、REPLACE、REFILL五个状态,设计时一定先明白每个状态在更新什么、还是需要等什么。
除了Request Buffer,还需要记录替换路、返回字计数等缺失信息。对总线返回的计数只能在ret_valid有效时增加,不能因为进入了REFILL就每拍自增,AXI返回的数据中间是可以有空拍的。
写命中时,手册使用单独的Write Buffer保存命中的路、Index、Bank、字节使能和写数据,下一拍再真正写入RAM。这可以把Tag比较到Data写入的路径隔开。
但缓冲也会带来新问题:后一条load可能恰好读取尚未落入RAM的store数据。初次实现建议使用阻塞处理,并同时检查:
LOOKUP中正在处理的store与新load是否存在写后读相关。- Write Buffer正在写的Bank与新load需要读的Bank是否存在单端口冲突。即使Index不同,同一个单端口Bank也不能同时读写两个地址。
addr_ok表示请求被接收,data_ok表示向CPU返回本次操作的响应,Cache内部是否空闲则由状态机决定。比如提前返回了load需要的字,也不代表剩余重填已经完成。初次实现可以先缓存目标字,等整行接收完成再响应;如果采用手册中的提前响应方式,要保证每条请求只响应一次,且重填结束前不接收新的缺失处理。
初始化与验证
Cache刚开始运行时,所有行都应该无效。可以用初始化状态机逐组清除TAGV并清零D,清理完成前不接收请求;FPGA中也可以按手册配置RAM初始内容为0,再复位D寄存器。(但是还是建议完全交由逻辑控制)
调试Tips
- 第一次请求应该缺失;同一行填入后再访问其它字,应该命中。如果一直miss,先查V和Tag写入,再查比较时请求是否对拍。
- 给同一Index配置三个不同Tag的地址,先分别写入不同数据,再读回来,检查脏行写回和重填。只读同一行测不出替换错误。
- 分别检查
st.b、st.h是否保留了未被写使能选中的字节,再检查store后紧跟load的情况。 - 调试重填时把
ret_valid、ret_last、返回字计数、Bank写使能放在一起看。最后一拍也要先把数据正确写入,再结束这一轮重填。 - 波形中同时保留原请求地址和被替换行地址,很多“数据差一点”的问题其实是写回地址错了。
附录
在学习之前,你需要
多路复选器
作用:从一组输入数据中选出某一个来

核心:用与门当做开关,通过数据信号和控制信号相与实现各数据的选择效果
二选一
电路图:
verilog实现方式:
- 门级电路(了解即可)
| |
- 行为级描述
| |
- 带参数的常用写法
| |
调用方式
| |
四选一
电路图:
verilog实现方式:
- 门级电路(了解即可)
| |
- 行为级描述
| |
- 带参数的常用写法
| |
调用方式
| |
本章你需要学会的
- 带参数的写法及其调用方法
加法器
半加器
只将两个1位二进制数相加,不考虑低位进位。
- 真值表
| 输入 | 输出 | ||
| A | B | S | CO |
| 0 | 0 | 0 | 0 |
| 0 | 1 | 1 | 0 |
| 1 | 0 | 1 | 0 |
| 1 | 1 | 0 | 1 |
- 逻辑函数
- 电路图

- verilog实现方式
| |
全加器
除了要将两个1位二进制数相加外,还有考虑来自低位的进位。
- 真值表
| 输入 | 输出 | |||
| CI | A | B | S | CO |
| 0 | 0 | 0 | 0 | 0 |
| 0 | 0 | 1 | 1 | 0 |
| 0 | 1 | 0 | 1 | 0 |
| 0 | 1 | 1 | 0 | 1 |
| 1 | 0 | 0 | 1 | 0 |
| 1 | 0 | 1 | 0 | 1 |
| 1 | 1 | 0 | 0 | 1 |
| 1 | 1 | 1 | 1 | 1 |
逻辑函数可以通过两个半加器串联修改实现
- 电路图

- verilog实现方式
| |
多位加法器
行波进位加法器(Ripple-carry adder)
- 示意图

如同波一般向前计算。每次运算需要等待前一位的进位值,由全加器的电路图可知,从cin到cout有两级门电路的时延,所以对于N位行波进位加法器,时延就是$3+(N-1)*2=2N+1$级。可见,在位数更高的RCA中,串行计算带来的时延会相当大,这对于现代高速运算是不可忍受的。
- verilog实现方式
| |
超前进位加法器(Carry-lookahead Adder)
为了提高运算速度,必须设法减小或消除由于进位信号逐级传递所耗费的时间,于是设计出超前进位加法器。
超前进位逻辑
两个多位数中第i位相加产生的进位输出$(CO)_i$可表示为
$$ (CO)_i=A_iB_i+\left( A_i+B_i\right) \left( CI\right)_i $$我们将$G_i = A_iB_i$称为进位生成函数,将$P_i = (A_i+B_i)(CI)_i$称为进位传递函数。
通过数学计算展开可得
$$ \left( CO\right) _{i}=G_{i}+P_{i}G_{i-1}+P_{i}P_{i-1}G_{i-2}+\ldots +P_{i}P_{i-1}\ldots P_{1}G_{0} +P_{i}P_{i-1}\ldots P_{0}G_{0} $$于是我们得到了任意一位产生的进位,避免了等待进位信号的逐级传递,将实现上述逻辑的电路称为CLU(Carry Lookahead Unit)。由公式可以看出,并行生成各级$C_i$的时延来自$G_i$和$P_i$的先与后或,再加上生成$G_i$和$P_i$的一级门电路,总共是三级门电路时延。而且可以看出,时延的级数并不会随位数的增加而增加,不论多少位CLA,生成各级$C_i$的时延恒为三级门电路。
由全加器的真值表可得第$i$位和$S_i$的逻辑式
$$ S_i=A_i\oplus B_i\oplus (CI)_i \ \ \ 或 \ \ \ S_i= \sim G_i P_i\oplus (CI)_i $$同样不超过三级门电路
4位超前进位加法器
| |
更多位超前进位加法器
在设计出4位超前进位加法器后,一个很自然的想法是:要想得到更多位CLA,只需像4位CLA那样,只是多递归几次的区别。这个方法叫全超前进位。全超前进位理论上是可行的,但由CLU的公式可知,随着位数的增加,实现CLU的门电路数量会急剧增加,导致电路面积开销过大;另一方面,位数的增加也会使扇入飞速增大,导致时延增加。
所以,单纯的递归并不是好的解决方案。
一个解决方案是借鉴RCA。将多个4位CLA级联,即采用“组内超前进位,组间串行进位“来构成更多位超前进位加法器。其中每个4位CLA从进位输入到进位输出是两级门电路时延,加上第一级CLA的PG时延和最后一级CLA的异或门时延,这种方式构成的N位超前进位加法器的总时延为$1+2*(N/4)+1=N/2+2$。
如果想获得更快的速度,就得采用另一种方法——多级超前进位加法器。多级超前进位加法器采用“组内超前进位,组间也超前进位”的方式,可进一步降低因组间串联进位带来的时延。即将每个4位CLA看做一位再由超前进位逻辑再次进行超前进位,故称为多级超前进位加法器。
本章你要学会的
- 超前进位加法器是怎么优化降低时延的
- generate-for循环调用模块
一些可参考资料
- 《数字电子技术基础》阎石 p172-176
- 《计算机体系结构基础》胡伟武 p188-193
- 32位超前进位加法器的设计-T-Tang-电子技术应用-AET-中国科技核心期刊-最丰富的电子设计资源平台 (chinaaet.com)
- 16位两级超前进位加法器的Verilog实现及时延分析 - 知乎 (zhihu.com)
乘法器
不采用任何优化算法的乘法过程,可以用我们小学就学过的列竖式乘法来说明。从乘数的低位开始,每次取一位与被乘数相乘,其乘积作为部分积暂存,乘数的全部有效位都乘完后,再将所有部分积根据对应乘数数位的权值错位累加,得到最后的乘积。

这样原始的乘法在设计上是可以实现的,但在工程应用上几乎不会采用,在时延与面积上都需要优化。一个N位的乘法运算,需要产生N个部分积,并对它们进行全加处理,位宽越大,部分积个数越多,需要的加法器也越多,加法器延时也越大,那么针对乘法运算的优化,主要也就集中在两个方面:一是减少加法器带来的延时,二是减少部分积的个数。
补码移位乘法器
首先解决负数乘法问题。在加减法中我们采用补码解决负数和减法问题,在负数乘法中同样可以使用补码。
假定有 8 位定点数 $Y$, $[Y]_补$ 的二进制格式写作 $y_7 y_6 y_5 y_4 y_3 y_2 y_1 y_0$ ,根据补码定义,$Y$ 的值等于
$$ Y=y_{7}\times -2^{7}+y_{6}\times 2^{6}+y_{5}\times 2^{5}+\ldots +y_{0}\times 2^{0} $$由此可得出
$$ \begin{aligned}\left[ X\times Y\right] _{补}&=\left[ X\times (y _{7}\times -2^{7}+y_{6}\times 2^{6}+\ldots +y_{0}\times 2^0) \right]_{补} \\ &=\left[X \times -y_7\times 2^{7}+X\times y_{6}\times 2^{6}+\ldots +X\times y_{0}\times 2^{0}\right] _{补}\\ &=\left[ X\times-y_{7}\times2^{7}\right] _{补}+\left[ X\times y_6\times 2^{6}\right] _{补}+\ldots +[ X\times y_{0}\times 2^{0}) _{补}\\ &=-y_{7}\times \left[ X \times 2^{7} \right] _{补} + y_{6}\times \left[ X \times 2^{6} \right] _{补}+\ldots +y_{0}\times \left[ X\times 2^{0}\right]_{补}\\ &=\left[ X\right] _{补}\times \left( -y_{7}\times 2^{7}+y_{6}\times 2^{6}+\ldots +y_{0}\times 2^{0} \right) \end{aligned} $$根据公式可以用verilog设计出简单的移位补码乘法器
| |
华莱士树
由于累加器本身的进位传递延时对电路性能依然存在非常大的影响,所以优化的第一个方面,就是改进部分积累加结构,提升累加性能。如果采用部分积直接相加的方式,因为全加器进位的关系,当前bit的相加结果依赖于它前一bit的进位输出,整个计算过程相当于串行化,位宽越大,延时越大,所以优化的关键就是消除进位链,使运算并行化。
进位保留加法器(Carry Save Adder, CSA)是比较常用的一种优化方式,CSA实际上就是一位全加器。在上一章中我们学习了全加器有3个输入A,B,CI和2个输出S,CO,通过CI和上一级CO相接实现串行的加法,但是在CSA中我们保留每一位的CO,CI使用另外一个加数D来替代,即
$$ A+B+D=S+\{C,0\} $$这样我们就实现了3个加数变为2个加数的加数缩减,也就是说我们将加数减少了1/3,如果我们再往后加一层同样的CSA,可以进一步减少加数,直到只剩两个加数即可使用一个加法器得到最终结果。对于N个加数的加法,使用串行加法器需要N-1个加法器的延时,使用多层华莱士树大致需要$log_{1.5}(0.5N)$个加法器延迟,显然明显地降低计算延迟,数据宽度越宽,其效果越明显。
下面为8个1位数相加的四层华莱士树结构图,同样也可将1位数扩展为多位数,结构是相似的。
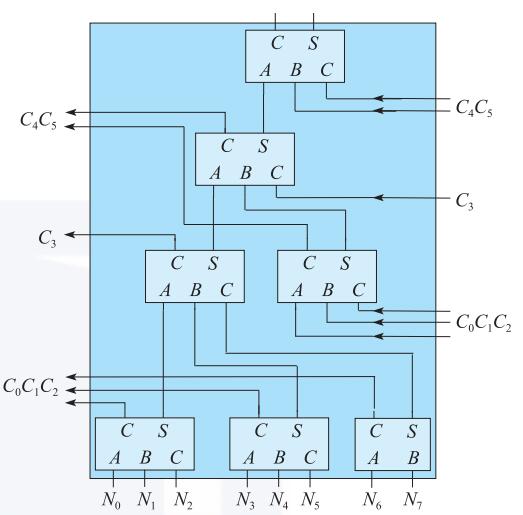
注意每一层的进位信号只能接到下一层,不能接到上一层
| |
同样也可以设计4-2压缩的华莱士树
booth乘法器
如果遵循第一节的补码乘法算法,需要特地挑出第 N 个部分积,并使用补码减法操作,这就需要实现一个额外的状态机来控制,增加了硬件设计复杂度。 因此对补码乘法公式进行变换
$$ \begin{aligned} Y&=-y_{7}\times 2^{7}+y_{6}\times 2^{6}+y_{5}\times 2^{5}+\ldots +y_{0}\times 2^{0}\\ &=\left( -y_7 \times 2^{7}+\left( y_{6}\times 2^{7}-y_{6}\times 2^{6}\right) +\left( y_{5}\times 2^{6}-y_{5}\times 2^{5}\right) +\ldots +\left( y_1\times 2^{2}-y_1\times 2^{1}\right) +\left( y_{0}\times 2^1- y_{0}\times 2^{0}\right) +\left( 0\times 2^{0}\right) \right) \\ &=\left( y_{6}-y_{7}\right) \times 2^{7}+\left( y_{5}-y_{6}\right) \times 2^{6}+\ldots +\left( y_{0}-y_{1}\right) \times 2^{1}+ \left( y_{-1}-y_{0}\right) \times 2^{0}\end{aligned} $$其中$y_{-1}$取值为 0。 经过变换,公式变得更加规整,不再需要专门对最后一次部分积采用补码减法,更适合硬件实现。 这个新公式被称为 Booth 一位乘算法。
根据算法公式,很容易得出它的规则
| $y_i$ | $y_{i-1}$ | 操作 |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | $+[X]_补$ |
| 1 | 0 | $-[X]_补$ |
| 1 | 1 | 0 |
于是我们可以设计出booth一位乘
| |
在 Booth 一位乘算法中,为了计算 N 位的补码乘法, 依然需要 N-1 次加法。 而数据宽度较大的补码加法器面积大、电路延迟长,限制了硬件乘法器的计算速度,所以优化的第二个方面就是减少部分积的个数。重新对补码乘法公式进行变换,得到 Booth 两位乘算法。
$$ 𝑌=(𝑦_5+𝑦_6−2𝑦_7 )×2^6+(𝑦_3+𝑦_4−2𝑦_5 )×2^4+⋯+(𝑦_{−1}+𝑦_0−2𝑦_1 )×2^0 $$根据算法公式,很容易得出它的规则
| $y_{i+1}$ | $y_{i}$ | $y_{i-1}$ | 操作 |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 0 | 1 | $+[X]_补$ |
| 0 | 1 | 0 | $+[X]_补$ |
| 0 | 1 | 1 | $+2[X]_补$ |
| 1 | 0 | 0 | $-2[X]_补$ |
| 1 | 0 | 1 | $-[X]_补$ |
| 1 | 1 | 0 | $-[X]_补$ |
| 1 | 1 | 1 | 0 |
于是你们就可以设计一个8位booth二位乘乘法器了
本章你要学会的
- 补码乘法
- 并行化优化思路
一些参考资料
- 《计算机体系结构基础》胡伟武 p196-206
- 《CPU设计实战》p140-146
- 乘法器的布斯算法原理与VERILOG实现 - 知乎 (zhihu.com)
- 八位“Booth二位乘算法”乘法器 - 知乎 (zhihu.com)
除法器
符号解释:
- $N$ = numerator (dividend),分子,被除数
- $D$ = denominator (divisor),分母,除数
- $Q$ = quotient,商
- $R$ = Remainder,余数
循环相减法
最简单粗暴的法子,减到没法减。
其伪代码如下
| |
慢速算法(迭代)
以下恢复余数法、非恢复余数法、SRT算法均是慢速算法,其共同点为通过循环等式,对余数R进行迭代:
$$ R_{j+1} = B \times R_j - q_{n-(j+1)} \times D $$其中:
- $R_j$ 是第 $j$ 个部分余数,$R$ = $R_n$ ,$N$ = $R_0$
- $B$ 是基,在二进制中,为2
- $q_{n−(j+1)}$ 是商的第 $n−(j+1)$ 位,例如第1次迭代(j=0)产生 $q_{n−1}$ ,商的最高位
- $n$ 是商的位数
- $D$ 是除数
注意要将N(被除数)左移n位
恢复余数法
恢复余数法无法直接用于与有符号数,对于有符号数需要先转换为无符号数,然后根据除数与被除数的符号判断商与余数的符号。
其算法核心是在每次迭代时都假定$q$为1,计算出下一个部分和。然后判断该部分和的正负性,如果为正则假定正确,即该位商为1;如果为负则假定不正确,即该位商为0,且将部分余数恢复为正(即将减去的除数加回去)。
算法伪代码如下:
| |
非恢复余数法
在非恢复余数法中,使用{-1,1}替代{0,1},同时去除恢复余数的冗杂步骤,根据该位商情况迭代不同的。
$-3 = (-1)(1)(1)(-1) = -2^3 + 2^2 + 2^1 - 2^0$
算法伪代码如下:
| |
On-The-Fly算法
由于非恢复余数法中的商出现了负数,直接得出的商是非标准形式的,我们需要把非标准形式的商在算法的最后一步转换为标准形式,但是它需要耗费额外的延迟以及芯片面积。
On-the-fly转换是为了获得实时的转换结果而设计的,它仅仅使用2个Flip-Flop和一些简单的组合逻辑就可以完成转换过程。
Q的值在每次迭代中的更新公式为:
$$ Q_{j+1} = Q_j + q_{j+1}r^{-(j+1)} $$在存在负数的商位的情况下:
$$ Q_{j+1} = \left\{\begin{matrix} Q_j + q_{j+1}r^{-(j+1)} & , q_{j+1} \ge 0\\ Q_j - r^{-j} + (r-\left | q_{j+1} \right | )r^{-(j+1)} & , q_{j+1} < 0 \end{matrix}\right. $$该更新公式有一个缺点,需要做减法,进位的传播会使电路变得很慢,因此我们定义另一个寄存器$QM_{j+1} = Q_j - r^{-j}$。于是减法操作可替换为对寄存器 QM 进行采样。
此时两个寄存器的更新公式为:
$$ Q_{j+1} = \left\{\begin{matrix} Q_j + q_{j+1}r^{-(j+1)} & , q_{j+1} \ge 0\\ QM_j + (r-\left | q_{j+1} \right | )r^{-(j+1)} & , q_{j+1} < 0 \end{matrix}\right. $$ $$ QM_{j+1} = \left\{\begin{matrix} Q_j + q_{j+1}r^{-(j+1)} & , q_{j+1} > 0\\ QM_j + (r-\left | (r-1)-q_{j+1} \right | )r^{-(j+1)} & , q_{j+1} \le 0 \end{matrix}\right. $$初始化条件为:
$$ Q = QM = \left\{\begin{matrix} 全0 & , 商为正\\ 全1 & , 商为负 \end{matrix}\right. $$一些参考资料
类SRAM-AXI转接桥
龙芯杯团队赛中曾经提供的一个转接桥参考,效率偏低,且不支持burst传输。
| |
Linux 内核中4MB页大小对应的是透明大页的页表项,其在填入TLB过程中等分为2个2MB大小相同页表属性的表项。 ↩︎
存储访问类型见下文存储访问类型与Uncache。 ↩︎